
主题
Agentic RAG
本章目标
理解 RAG 的检索、上下文与生成三个阶段;分清一次检索和按证据质量迭代的 Agentic RAG;能检查回答引用。
前置:工具调用。这里先不要求你了解向量数据库。
补充讲解:像开卷答题一样回答文档问题
用户问“购买后多久能退款”,模型可能记得互联网中的常见说法,却不知道你公司的政策。检索增强生成(Retrieval-Augmented Generation,RAG)先找出相关文档片段,把片段连同问题提交给模型,再要求回答给出来源。这类似开卷答题,但检索可能漏题、资料可能过期、模型也可能读错,因此引用不是正确性的保证。
文档处理通常有五步:解析原文件、按语义分块、保存来源与权限、建立检索索引、在查询时选取候选。向量嵌入(Embedding)把文本变成数值向量,便于按语义相似度查找;向量数据库存储这些向量。RAG 也可以使用关键词搜索、SQL 或字典查找,并非必须先部署向量数据库。
图:本项目补充绘制。迭代改善证据覆盖的机会,也增加调用成本;不能无限循环。
模拟演示
0 / 5 步检索与引用实验
全部输入、请求与输出均为预设教学数据。这里展示应用流程,不代表模型内部推理。
点击“下一步”,观察信息如何流动。
原课程精读:Agentic RAG
本课全面介绍了 Agentic Retrieval-Augmented Generation(Agentic RAG),这是一种新兴的AI范式,大语言模型(LLM)在提取外部信息的同时,能够自主规划下一步操作。不同于静态的先检索后阅读模式,Agentic RAG涉及对LLM的迭代调用,穿插工具或函数调用及结构化输出。系统评估结果、优化查询、根据需要调用更多工具,并循环直到获得满意的解决方案。
介绍
本课内容包括
- 理解 Agentic RAG: 了解这一AI新范式,LLM能自主规划下一步操作并从外部数据源检索信息。
- 掌握迭代的Maker-Checker风格: 理解迭代调用LLM的循环,穿插工具或函数调用及结构化输出,以提高正确性并处理格式错误的查询。
- 探索实际应用: 识别 Agentic RAG适用的场景,如重视正确性的环境、复杂数据库交互和扩展的工作流。
学习目标
完成本课后,你将能够/了解:
- 理解 Agentic RAG: 掌握这一AI新兴范式,LLM自主规划下一步操作并从外部数据源获取信息。
- 迭代Maker-Checker风格: 理解迭代调用LLM的循环,穿插工具或函数调用及结构化输出,以提升正确性并处理格式错误查询。
- 掌控推理过程: 理解系统自主掌控推理流程,如何决定解决问题的方式而无需预定义路径。
- 工作流: 理解 Agentic模型如何自主决定提取市场趋势报告、识别竞争对手数据、关联内部销售指标、整合发现并评估策略。
- 迭代循环、工具集成与记忆: 了解系统基于循环交互模式,跨步骤保持状态与记忆,避免重复循环并作出明智决策。
- 故障处理与自我纠正: 探索系统强大的自我纠错机制,包括迭代重试、使用诊断工具以及依赖人工监督。
- 自主边界: 了解 Agentic RAG的局限性,关注领域特定的自主性、基础设施依赖及规范约束。
- 实际使用场景与价值: 识别 Agentic RAG发挥优势的场景,如重视准确性的环境、复杂数据库交互和延展工作流。
- 治理、透明度与信任: 了解治理和透明度的重要性,包括可解释推理、偏差控制及人工监督。
什么是 Agentic RAG?
Agentic Retrieval-Augmented Generation(Agentic RAG)是一种新兴的AI范式,LLM在检索外部信息的同时自主规划下一步操作。与静态的先检索后阅读模式不同,Agentic RAG涉及对LLM的迭代调用,穿插工具或函数调用和结构化输出。系统评估所获结果,优化查询,按需调用更多工具,循环执行直到获得满意方案。这种迭代的“maker-checker”风格提升了正确性,能处理格式错误的查询,确保高质量结果。
系统主动掌控其推理过程,重写失败的查询、选择不同检索方法、集成多种工具——如Azure AI Search的向量检索、SQL数据库或自定义API——然后才给出最终答案。Agentic系统的显著特点是能自主掌控推理流程。传统RAG只能依赖预定义路径,Agentic系统则根据所获信息的质量自主确定操作步骤序列。
定义 Agentic Retrieval-Augmented Generation(Agentic RAG)
Agentic Retrieval-Augmented Generation(Agentic RAG)是AI开发中的新兴范式,LLM不仅能够从外部数据源提取信息,还能自主规划下一步操作。不同于静态的先检索后阅读模式或精心编排的提示序列,Agentic RAG涉及迭代调用LLM的循环,穿插工具或函数调用和结构化输出。每一步系统都会评估结果,决定是否优化查询、调用额外工具,并循环直到满足条件。
这种迭代的“maker-checker”操作模式旨在提高正确性,处理向结构化数据库(如NL2SQL)提出的错误格式查询,并保证平衡且高质量的结果。系统不单靠精心设计的提示链,而是主动掌控推理流程,能重写失败的查询、选择不同的检索方法、整合多种工具——如Azure AI Search向量检索、SQL数据库或自定义API—最终给出结果。这样无需复杂的编排框架,只需“LLM调用→工具使用→LLM调用→…”的循环即可产出复杂且稳健的输出。
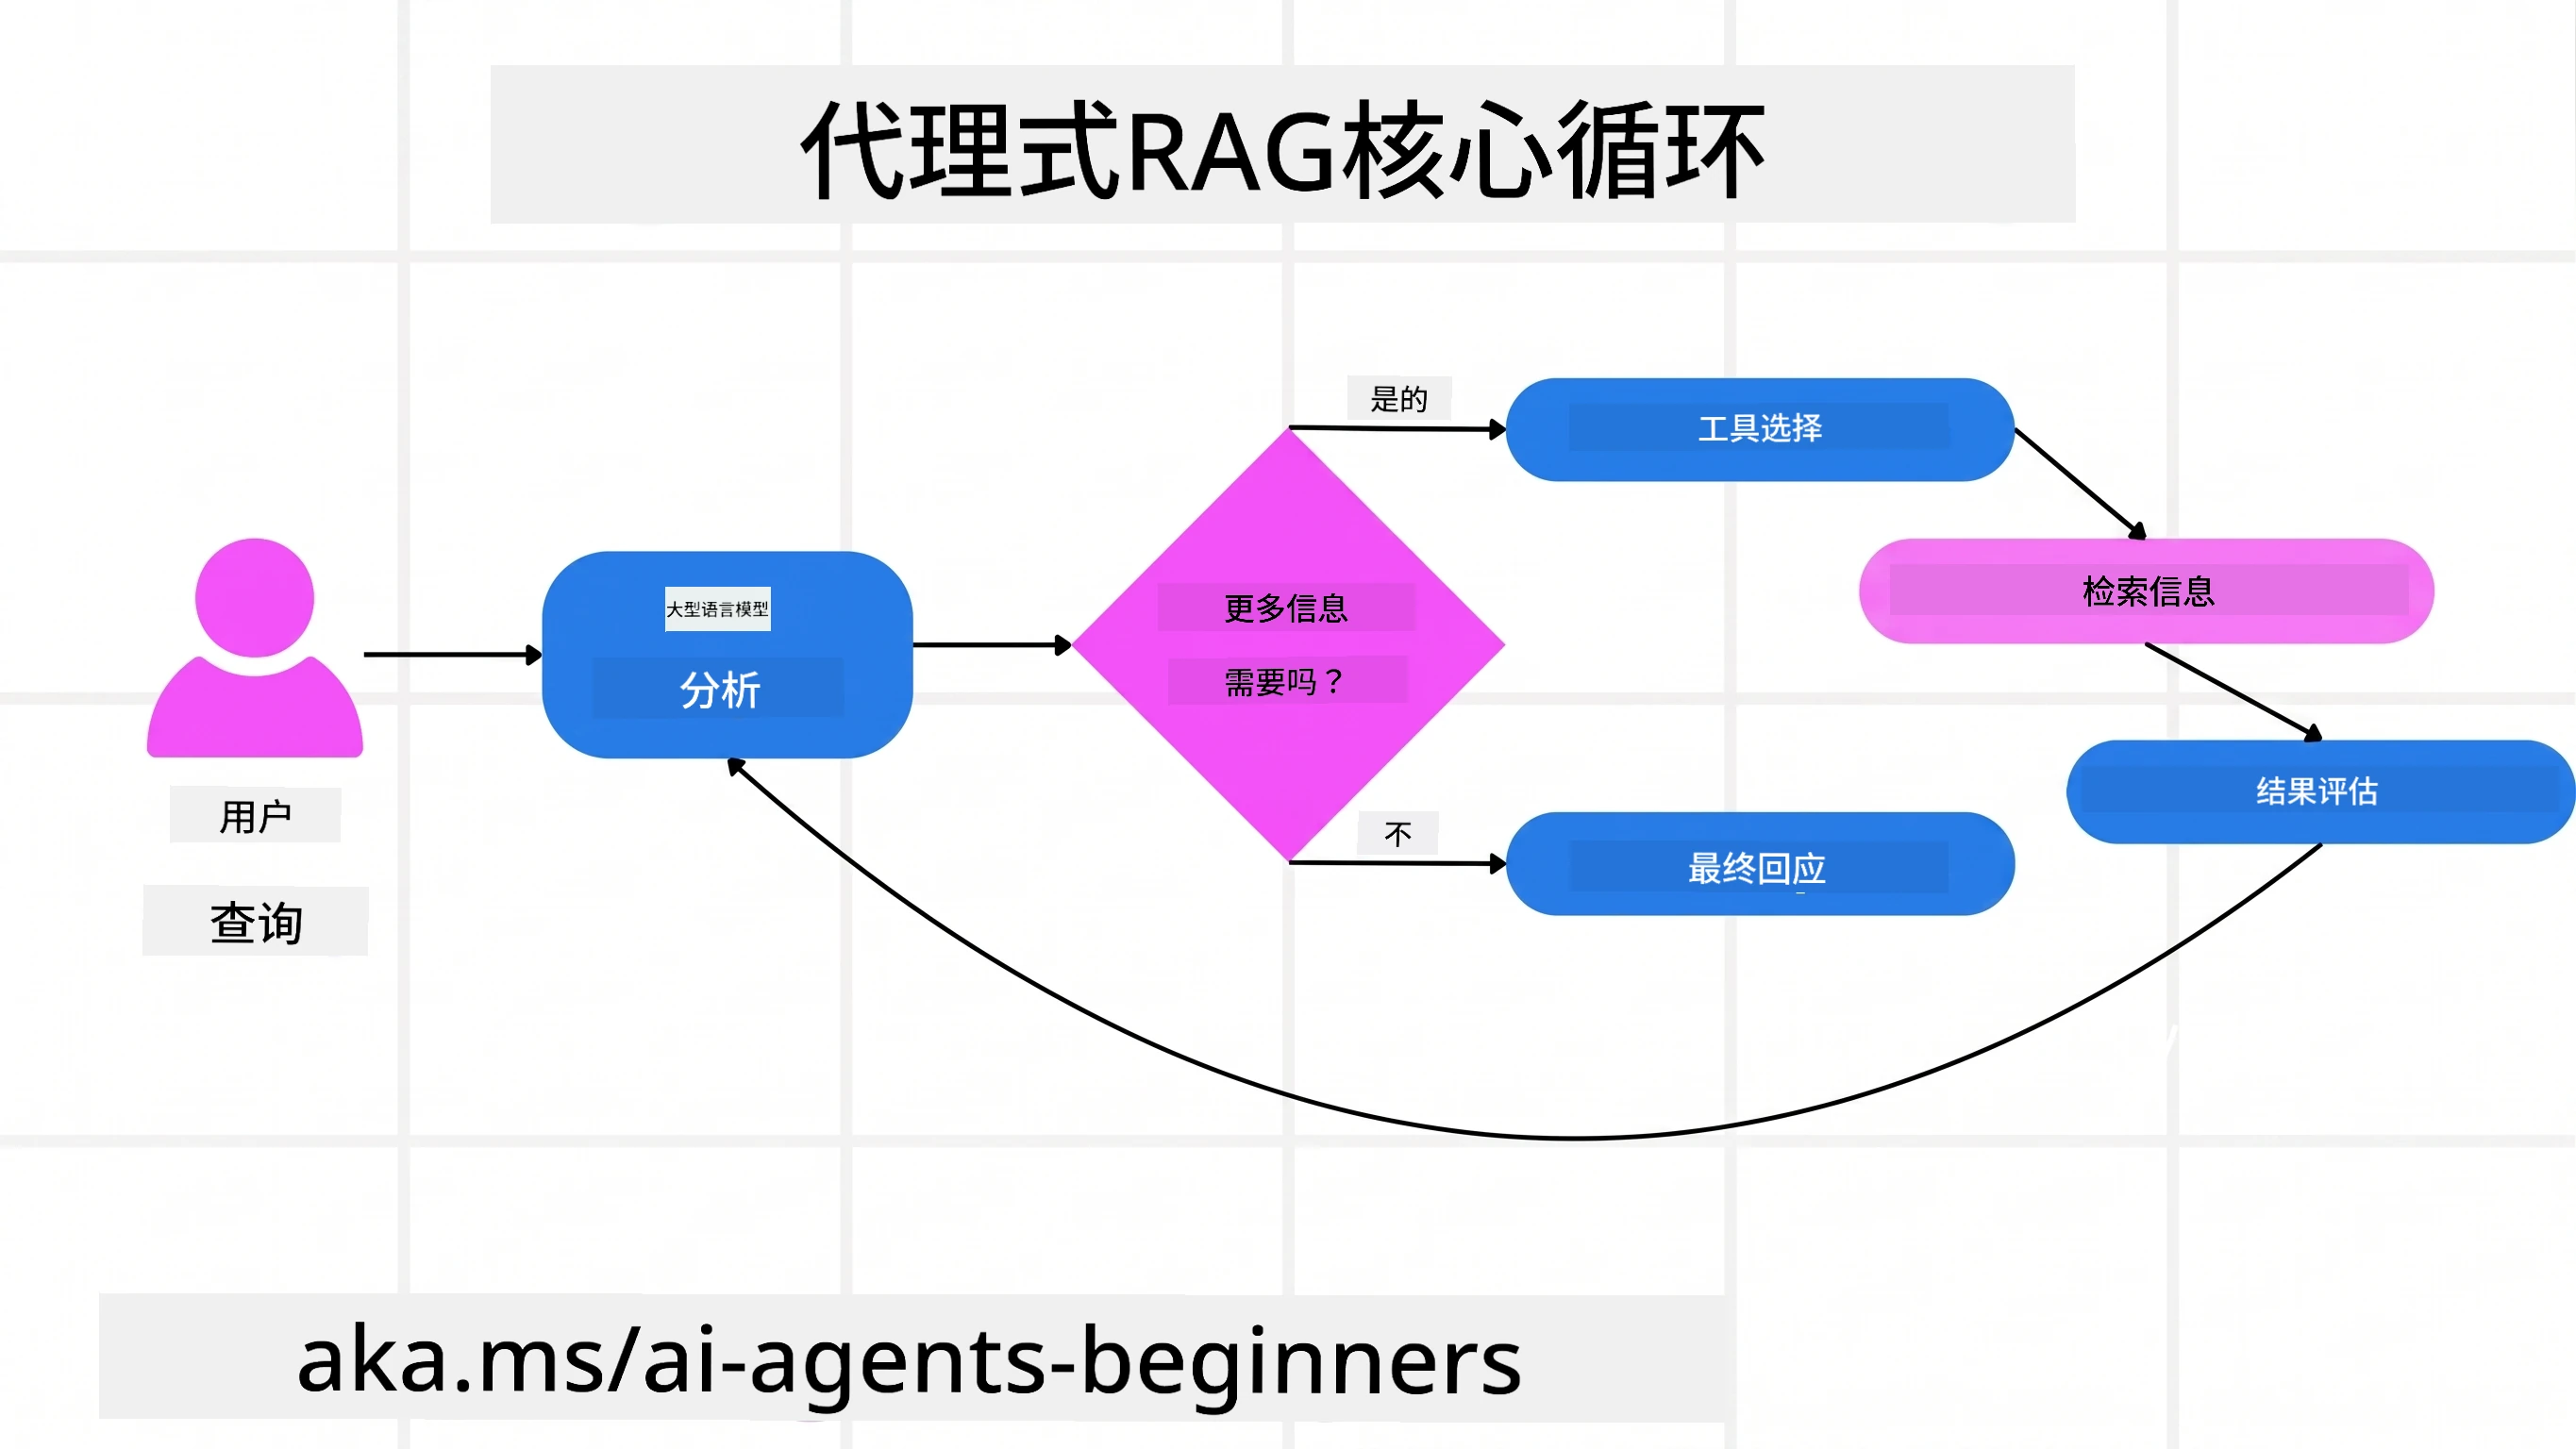
图:Agentic RAG Core Loop。来源:Microsoft AI Agents for Beginners,MIT。
掌控推理过程
系统被称为“Agentic”的关键特质是它自主掌控推理过程。传统RAG实现通常依赖于人类预定义模型的路径:一个指明何时检索什么内容的思维链。 但当系统真正具备 Agentic特质时,它则内部决定如何解决问题。它不仅仅执行脚本,而是基于所获信息质量自主确定步骤顺序。 举例来说,若被要求制定产品发布策略,Agentic模型不会仅依赖明确规定整个研究和决策流程的提示,而是自主决定:
- 使用Bing Web Grounding检索当前市场趋势报告
- 通过Azure AI Search识别相关竞争对手数据
- 运用Azure SQL数据库关联历史内部销售指标
- 通过Azure OpenAI服务将发现整合为连贯策略
- 评估策略中存在的遗漏或不一致,必要时再次检索 以上所有步骤——优化查询、选择信息来源、迭代直至“满意”答案——均由模型自主决定,而非人工预设。
迭代循环、工具集成与记忆
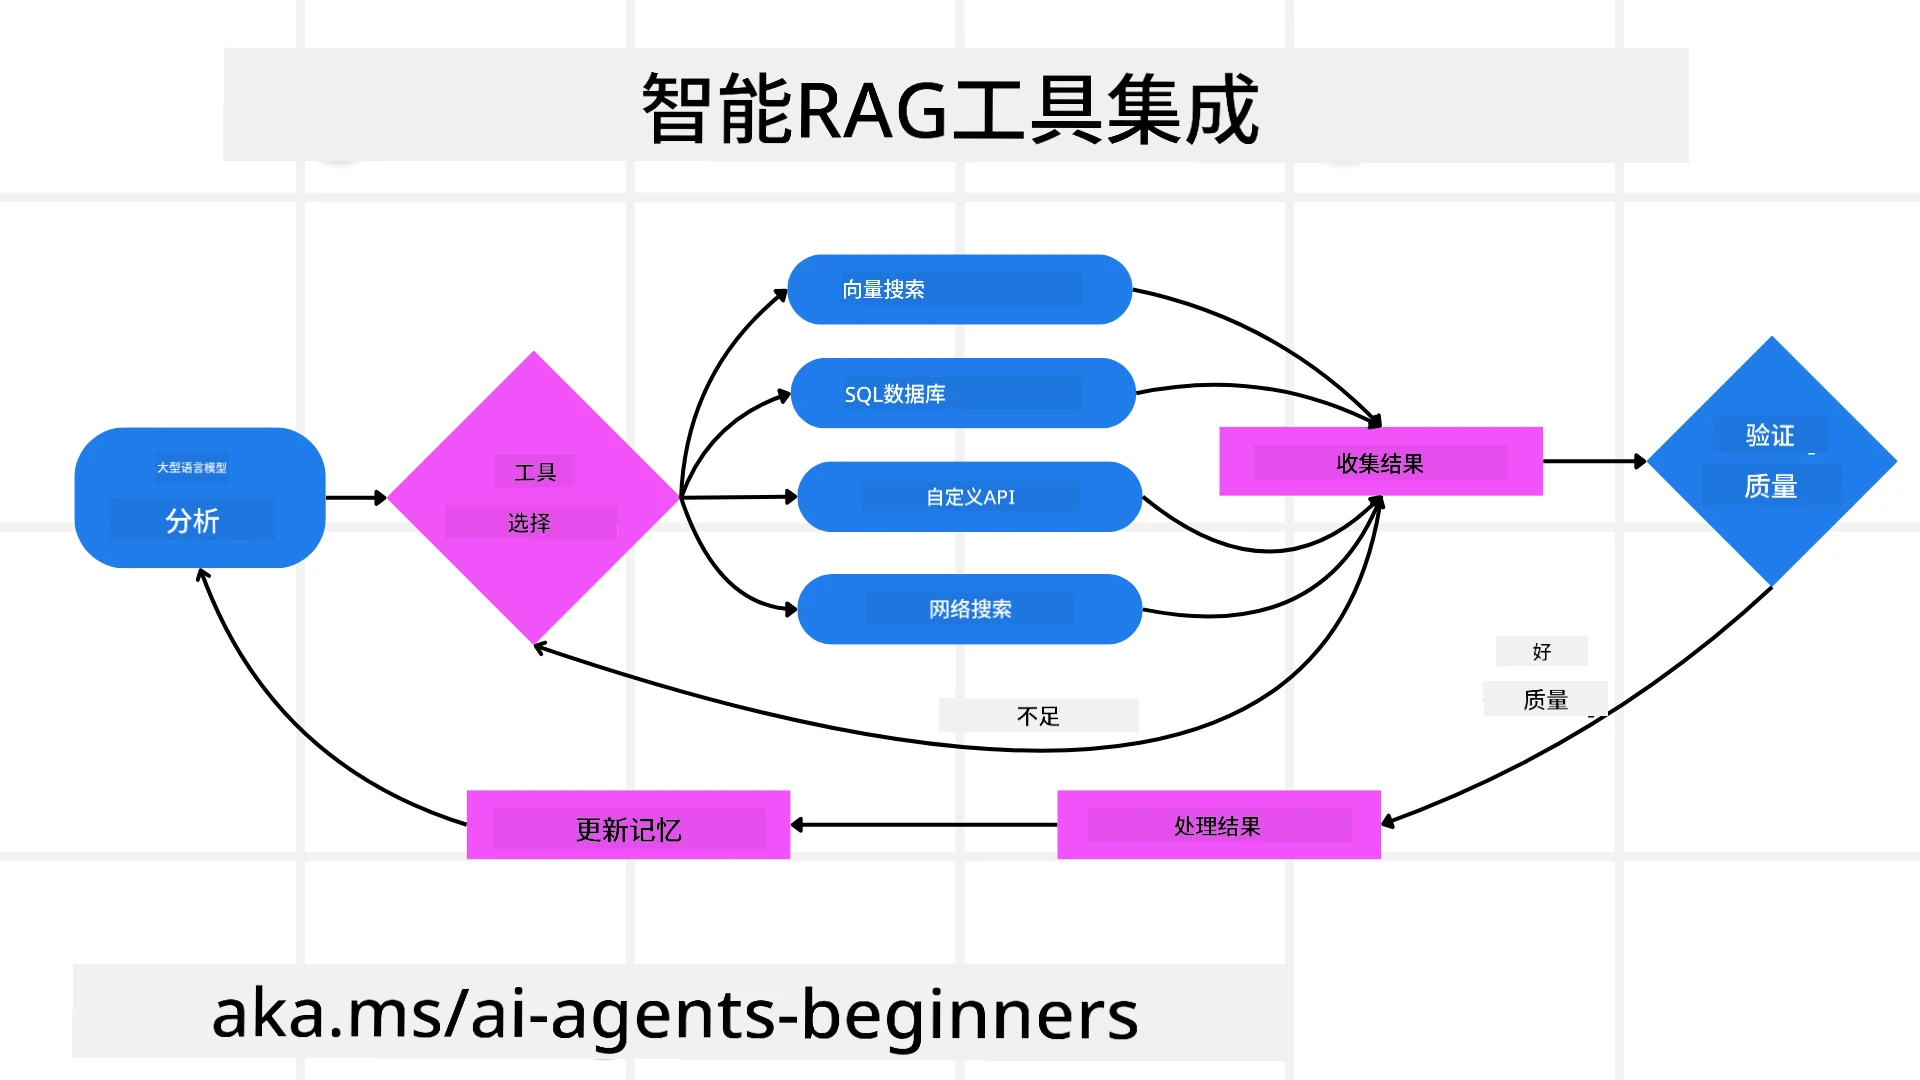
图:Tool Integration Architecture。来源:Microsoft AI Agents for Beginners,MIT。
Agentic系统依赖于循环交互模式:
- 初始调用: 用户目标(即用户提示)被传递给LLM。
- 工具调用: 若模型发现信息缺失或指令模糊,选择相关工具或检索方式—如向量数据库查询(例如Azure AI Search对私有数据的混合搜索)或结构化SQL调用—以获取更多上下文。
- 评估与优化: 评审返回数据后,模型判定信息是否充分。若不充分,则优化查询、尝试不同工具或调整策略。
- 循环至满意: 持续循环,直到模型判定已具有足够清晰度和证据来提供最终、合理的答复。
- 记忆与状态: 由于系统跨步骤保持状态和记忆,能回溯此前尝试及结果,避免重复循环并随着进展做出更明智的决策。
随着时间推移,模型形成不断发展的理解,能够应对复杂的多步任务,无需人工持续干预或调整提示。
处理失败模式与自我纠正
Agentic RAG的自主性还体现在其强大的自我纠错机制上。当系统遭遇死胡同——比如检索到无关文档或遇到格式错误的查询时——它可以:
- 迭代重试: 模型不返回低价值响应,而是尝试新搜索策略、重写数据库查询或查看替代数据集。
- 使用诊断工具: 系统可调用额外函数帮助调试推理步骤或确认检索数据正确性。Azure AI Tracing等工具对于实现健壮的可观测性与监控至关重要。
- 依赖人工监督: 在高风险或反复失败场景中,模型可能标记不确定性并请求人工指导。一旦获得人工纠正反馈,模型能将经验纳入后续推理。
这种迭代且动态的方法使模型持续改进,确保它不仅是一次性系统,而是能在单次会话中从错误中学习。
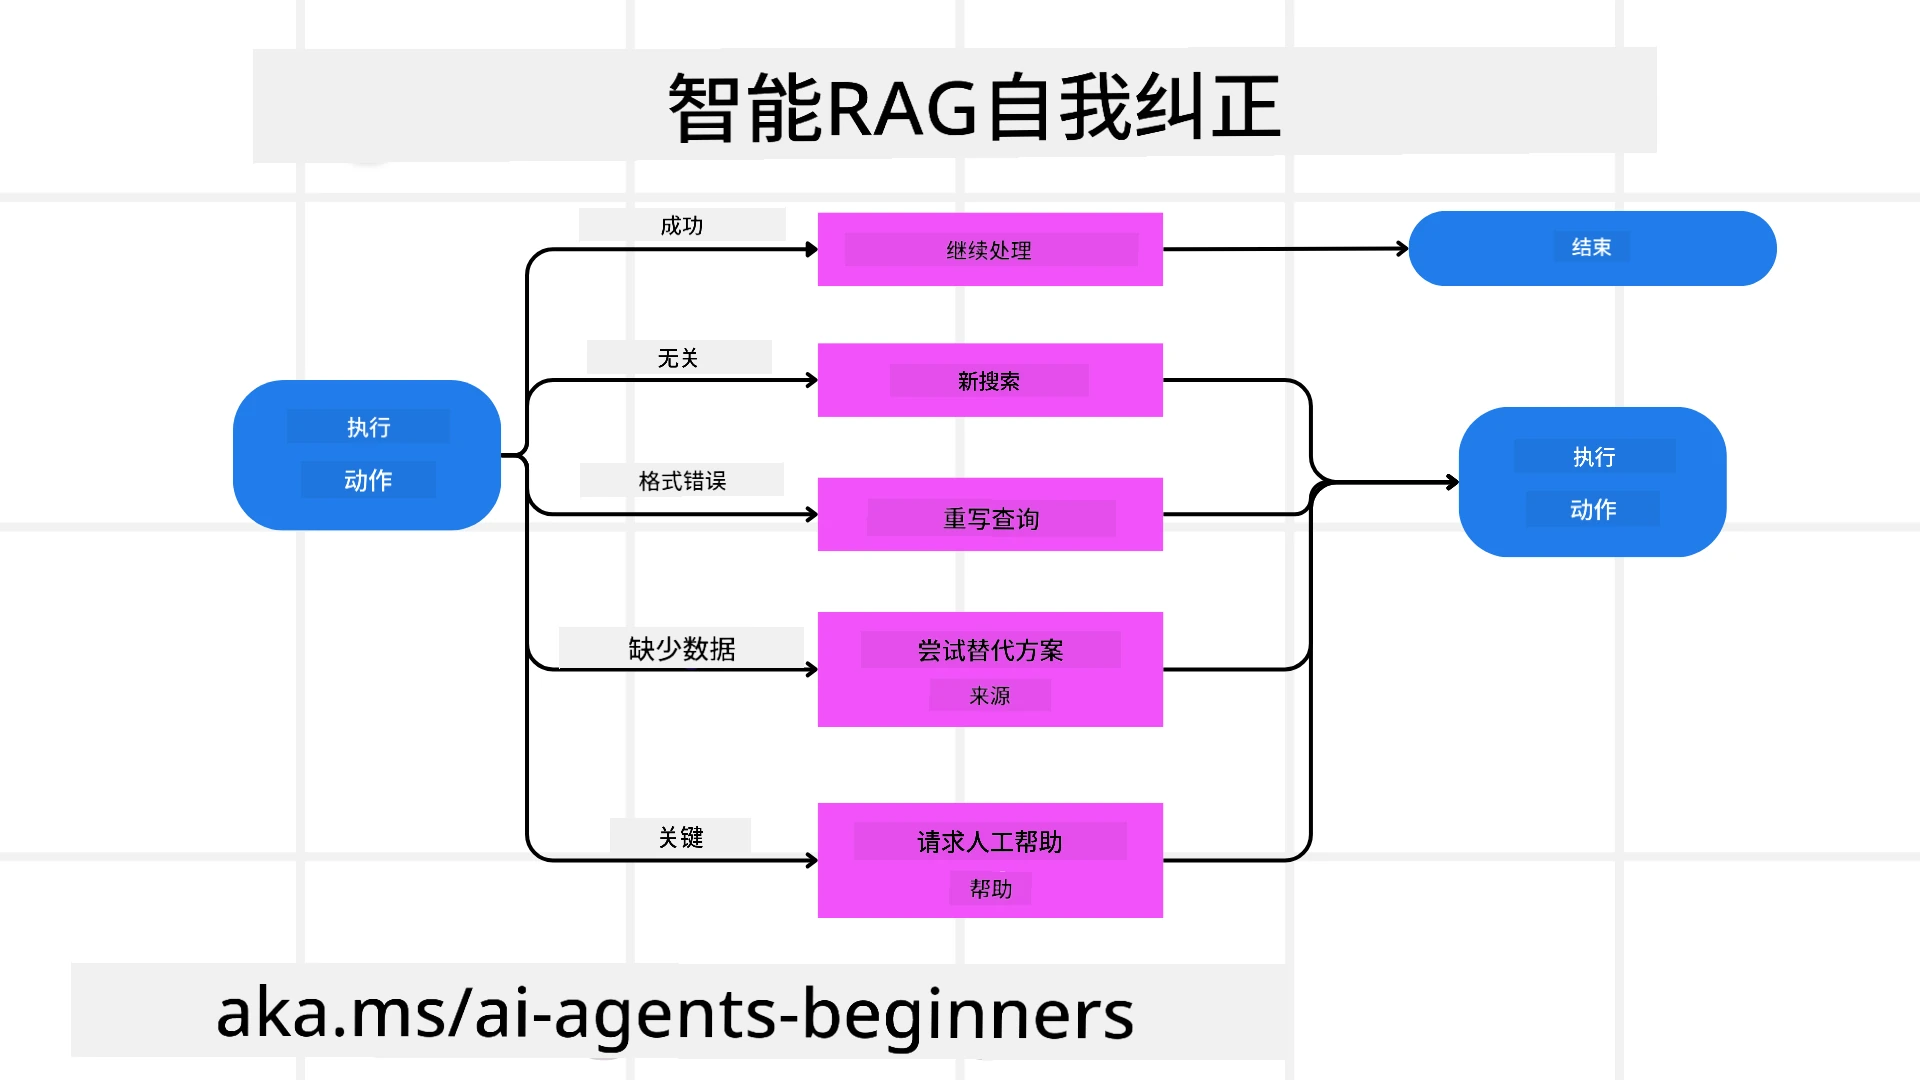
图:Self Correction Mechanism。来源:Microsoft AI Agents for Beginners,MIT。
自主性的边界
尽管在任务内具备自主性,Agentic RAG并非人工通用智能。其“自主”能力受限于人类开发者提供的工具、数据源和政策。它无法自创工具或突破设定的领域边界,而是在动态编排现有资源方面表现出色。 关键区别于更先进AI形式的地方包括:
- 领域特定的自主性: Agentic RAG专注于在已知领域内实现用户定义目标,采用如查询重写或工具选择等策略改善结果。
- 依赖基础设施: 系统能力取决于开发者集成的工具和数据,无法在无人干预下超越这些边界。
- 遵守规章: 道德准则、合规规则及业务政策极为重要。Agent 的自由始终受安全措施和监督机制约束(希望如此)。
实际使用场景与价值
Agentic RAG在需要迭代优化和精准度的场景中表现出色:
- 重视正确性的环境: 在合规检查、法规分析或法律研究中,Agentic模型能反复验证事实,咨询多源信息,重写查询,直到产出彻底审核的答案。
- 复杂数据库交互: 在处理结构化数据时,查询常失败或需调整,系统能自主优化查询(利用Azure SQL或Microsoft Fabric OneLake),确保最终检索符合用户意图。
- 延伸工作流: 长时间运行的会话会随着新信息涌现而发展。Agentic RAG能持续整合新数据,随着对问题领域认识的加深调整策略。
治理、透明度与信任
随着系统推理自主性增强,治理和透明度显得尤为关键:
- 可解释推理: 模型能提供查询轨迹、参考来源及达成结论的推理步骤记录。Azure AI内容安全、Azure AI追踪/GenAIOps等工具有助维护透明度与风险缓解。
- 偏见控制与平衡检索: 开发者可调优检索策略,确保涉及平衡且具代表性的数据源,定期通过定制模型审计输出,检测偏差或倾斜模式,尤其是使用Azure机器学习支持的高级数据科学组织。
- 人工监督与合规: 对于敏感任务,人工审查仍不可缺。Agentic RAG不能替代高风险决策中的人工判断,而是通过提供更为彻底审核的选项予以增强。
拥有可清晰记录操作的工具非常重要。缺乏时,对多步骤过程的调试会十分困难。下面是Literal AI(Chainlit背后公司)给出的 Agent 运行示例:
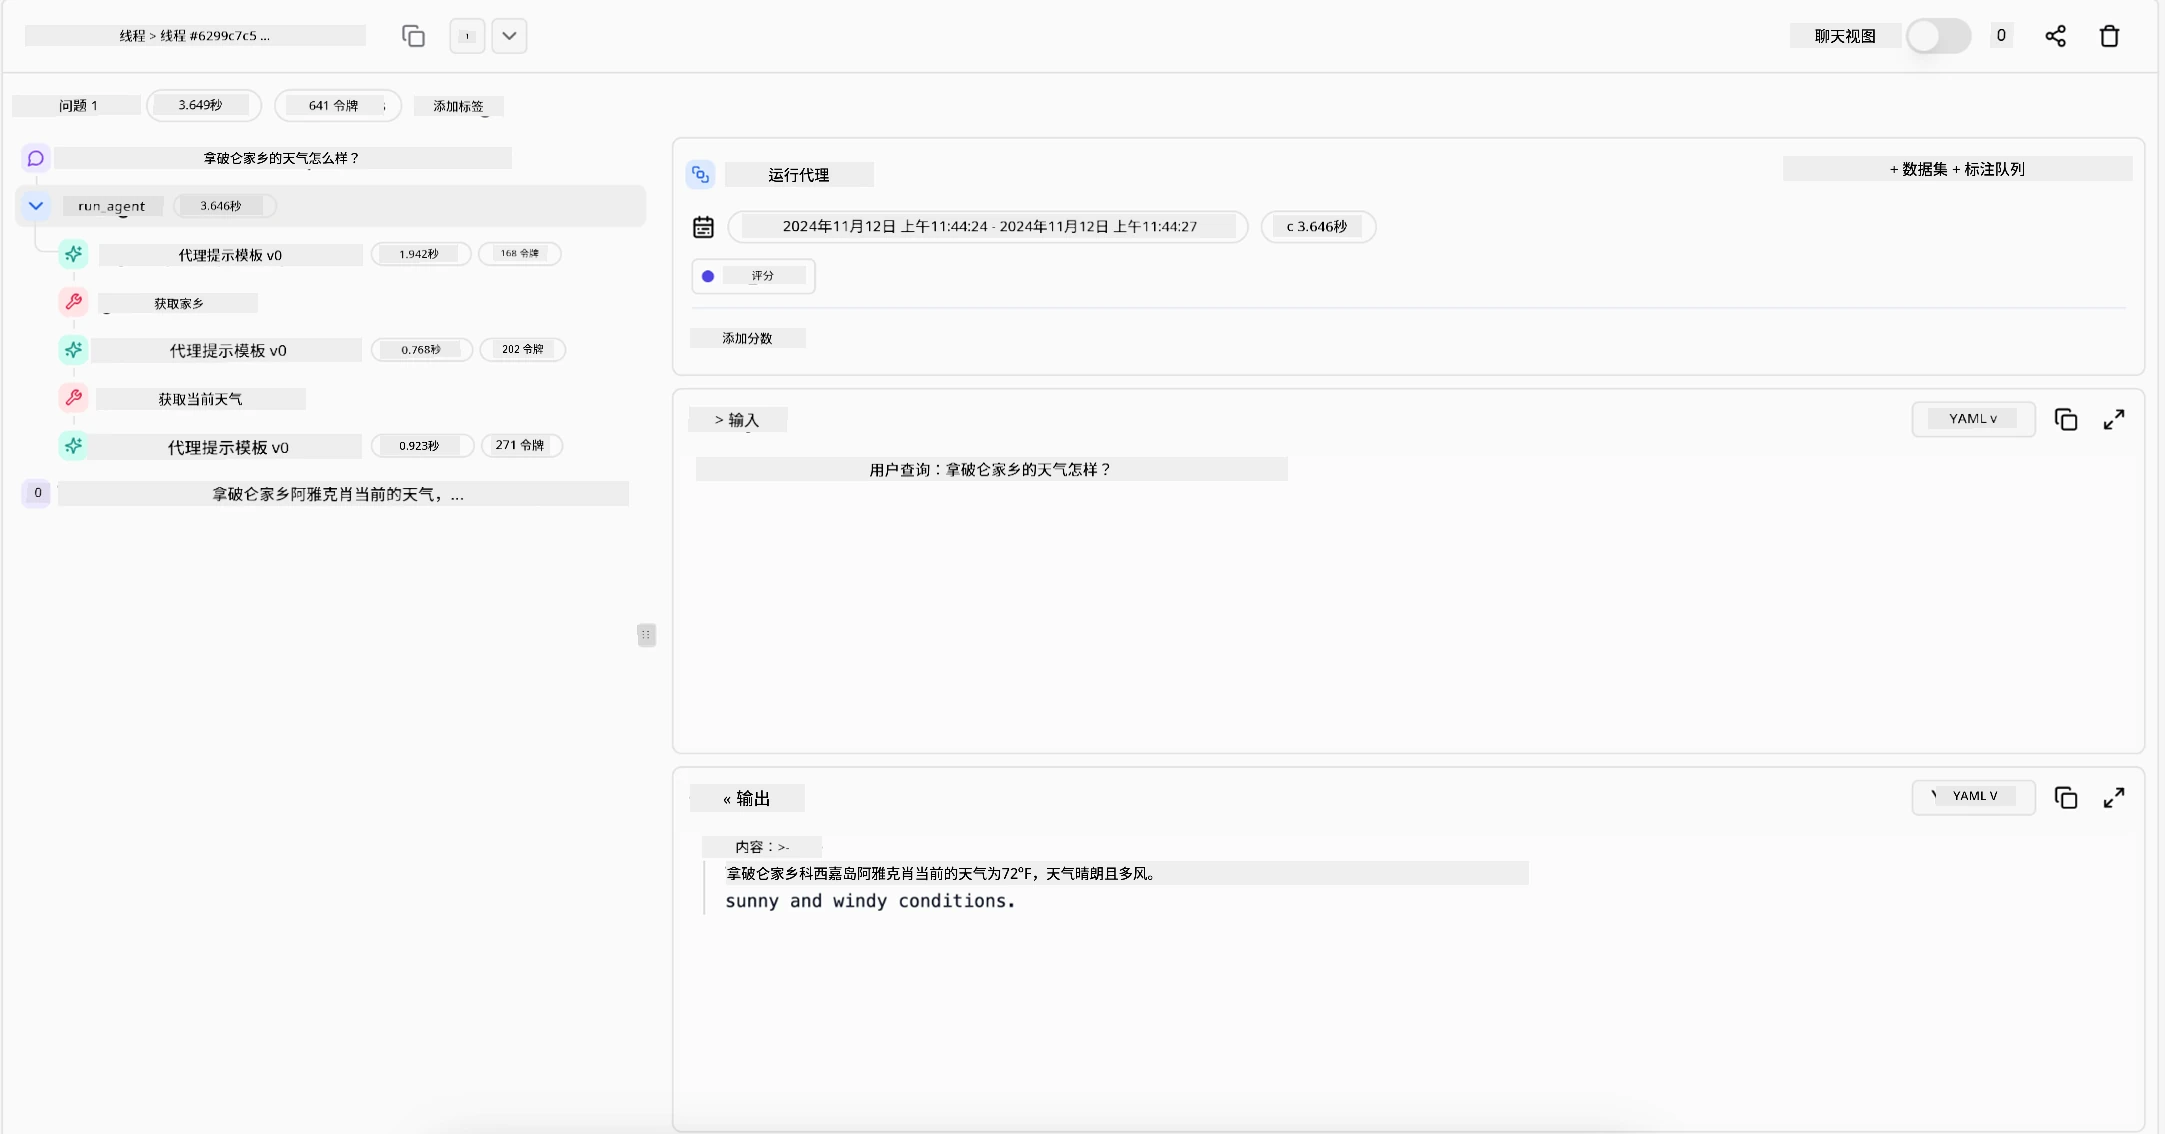
图:AgentRunExample。来源:Microsoft AI Agents for Beginners,MIT。
结论
Agentic RAG代表了AI系统处理复杂、数据密集型任务的自然演进。通过采用循环交互模式,自主选择工具,优化查询,直至获得高质量结果,系统超越了静态遵循提示的模式,成为更具适应性和上下文感知的决策者。虽然仍受限于人类定义的基础设施和伦理准则,这些 Agentic能力使企业和终端用户能够实现更丰富、更动态且更有用的AI交互。
额外资源
使用Azure OpenAI服务实现检索增强生成(RAG):学习如何用你自己的数据配合Azure OpenAI服务。本Microsoft Learn模块提供了全面的RAG实现指南
利用Microsoft Foundry评估生成式AI应用:本文涵盖模型在公开数据集上的评估与比较,包括 Agentic AI应用和RAG架构
学术论文
- 2303.17651 Self-Refine:带有自我反馈的迭代精炼
- 2303.11366 Reflexion:具有语言强化学习的语言 Agent
- 2305.11738 CRITIC:大语言模型通过工具交互式批评进行自我纠正
- 2501.09136 智能检索增强生成:智能RAG综述
快速测试该 Agent(可选)
在学习了如何在第16课中部署 Agent 之后,你可以通过tests/lesson-05-smoke-tests.json对本课的TravelRAGAgent进行快速测试——检查其回答是否基于知识库。有关如何运行测试,请参见tests/README.md。
完整案例:预算与季节共同约束旅行推荐
原 Python Notebook 用 TRAVEL_KNOWLEDGE_BASE 字典保存四个目的地的季节、特点和每日花费。search_travel_knowledge() 做字符串匹配,然后将匹配的文本返回给模型;它没有计算向量。checker_agent 要求先找候选,再按城市名称核对细节,这体现了“生成者—检查者(Maker–Checker)”式迭代。
当用户给出每日 175 美元和四月出行的约束时,要分别核实费用和适宜月份。一个城市符合建筑兴趣,不代表预算和季节都符合。应报告哪些条件被证据支持,哪些只有粗略区间;不能把区间均值冒充实际报价。
运行与代码解析
原代码入口是 05-agentic-rag/code_samples/05-python-agent-framework.ipynb。按准备篇安装 MAF 1.10.x、配置 Foundry 后启动 Jupyter。 该 Python Notebook 不要求 Azure AI Search,但仍调用云模型。 本章的 .NET 示例是另一条文件检索路径,不能混用其环境假设。
在无需 API 的扩展练习中执行:
bash
python3 examples/assistant/app.py '购买后多久可以退款?' --stage 3
python3 examples/assistant/app.py '火星上的酒店多少钱?' --stage 3第一条应包含 refund-policy 与 custom-policy 引用;第二条说明证据不足。retrieval.py 的 tokens() 做中文双字切分,search() 为关键词和重叠词打分,select_context() 按字符预算保留完整片段。这里的分数不是概率,也不是向量余弦相似度。
检索失败与工程边界
| 问题 | 可能原因 | 修复方向 |
|---|---|---|
| 有文档却没有命中 | 查询措辞、分块或索引不适合 | 加同义词、改写查询、检查片段是否被拆散 |
| 引用存在但答非所问 | 候选相似却不支持结论 | 检查引用是否覆盖每个关键主张,必要时重排 |
| 反复检索同一段 | 记忆与退出条件缺失 | 缓存已尝试查询,设置次数与时间预算 |
| 跨用户看到别人的资料 | 先检索后过滤权限 | 在检索边界加入用户/租户权限过滤 |
原文用“掌控推理过程”描述系统动态选择步骤。本教程将它理解为 可以观察的工具选择与执行轨迹 ,不声称日志揭示模型内部思考。检查器也可能和生成器犯同一种错;关键领域还需要独立验证和人工复核。
自测与练习
只检索“7 天可退款”,丢掉“未使用”和“定制商品例外”,会发生什么?
答案与参考实现
回答会遗漏约束,引用看起来存在却不完整。应同时选择主规则和例外条款。扩展项目保留两个不同来源 ID,测试 test_evidence_and_exceptions 同时检查两者。尝试把 --budget 设置为 0,预期回答证据不足,而不是继续引用未选入上下文的文档。
本章建立了证据链。下一章讨论系统面对错误输入、攻击和重大操作时如何维持可信边界。
原课程代码与补充材料
以下是本章实际源文件对应的阅读页。Notebook 已分解为说明、代码及原文件输出;云端示例未进行联网端到端验证。正文中的片段用于解释,运行时使用完整 Notebook 和准备篇的固定依赖。
- document.md
- 05-dotnet-agent-framework.cs
- 05-dotnet-agent-framework.ipynb
- 05-dotnet-agent-framework.md
- 05-python-agent-framework.ipynb
本章来源
基于 英文原文 与 简体中文翻译 整理,原作者为 Microsoft 与开源贡献者,采用 MIT 许可证。本页标明“补充讲解”与“扩展实践”的内容为本项目新增。
来源提交:25b7985f3b2d · 获取日期:2026-09-14。参见版本校订记录。