
主题
元认知与反思
本章目标与前置知识(补充讲解)
先完成规划与RAG。本章学习如何把“回答得不好”变成可以检测、有限重试的工程流程:定义评价标准、读取外部反馈、修订方案、决定何时停止。
用户说“帮我找便宜的酒店”,第一版找到了最低价但评分很差的房间。收到“至少四星”的反馈后,系统应更新约束并重新查询。 反思(Reflection)在这里是对候选结果的检查与修订;不是对模型是否具有意识的判断,也不是显示隐藏思维链。 原课程使用“元认知”“自我意识”等拟人化表述,以下都按可观察、可实现的反馈机制理解。
输入包括目标、候选方案、证据与评价规则;检查器输出具体缺陷和是否通过;执行器决定再检索、重排、修订,或达到预算后返回未解决事项。单纯让同一个模型说“我确信正确”不是可靠的评价证据。
阅读本章的方式
原文涉及旅行规划、纠错 RAG、预加载上下文、重排、意图搜索、生成代码和 SQL 等多个侧面。先读概念,再按本页末尾的“案例串联”对照。原文代码属于原理片段,存在示意 API 地址、旧 SDK、缺失实现与直接 exec;不要将其当作一套可直接安装运行的工程。
原课程代码片段的阅读范围
下方精读保留上游主要知识与片段,可能包含历史 SDK 写法、示意端点及未完整定义的函数;这些片段不等同于经过本站验证的完整程序。运行前优先阅读本章实际 Notebook 导读与版本校订。已验证的无 API 实验在“扩展实践”中另行标明。
原课程精读:AI Agent 中的元认知
介绍
欢迎来到关于 AI Agent 中元认知的课程!本章节针对对 AI Agent 如何思考自身思维过程好奇的初学者设计。完成本课后,你将理解关键概念,并配备实际示例,用于在 AI Agent 设计中应用元认知。
学习目标
完成本课后,你将能够:
- 理解 Agent 定义中推理循环的含义。
- 使用规划和评估技术帮助自我纠错的 Agent。
- 创建能够操作代码以完成任务的 Agent。
元认知介绍
元认知原指对认知过程的监控与调节。在本课程的工程语境中,指系统根据任务结果、外部反馈与评价规则检查并调整后续行动;这是一种反馈控制设计,不证明模型具有自我意识,也不要求展示隐藏推理。
在 Agent AI 系统的背景下,元认知可以帮助解决多个挑战,例如:
- 透明性:确保 AI 系统能解释其推理和决策过程。
- 推理能力:增强 AI 系统综合信息和做出合理决策的能力。
- 适应性:使 AI 系统能够适应新环境和变化的条件。
- 感知:提高 AI 系统识别和解读环境数据的准确性。
什么是元认知?
元认知设计模式让应用显式记录目标、候选方案、评价结果和修订动作。开发者能检查这些输出及其依据;它们与模型内部推理并不是一回事。
示例: “我优先考虑价格更便宜的航班,因为……我可能错过了直飞,所以让我再检查一下。”。 跟踪它为何选择某条路径。
- 注意到它犯了错误,因为过度依赖上次用户偏好,因此它不仅调整最终建议,还修改决策策略。
- 诊断模式,例如“每次看到用户提‘太拥挤’时,我不仅应该去除某些景点,还要反思如果我总按受欢迎程度排序‘顶级景点’,那我的挑选方法就是有缺陷的。”
元认知在 AI Agent 中的重要性
元认知在 AI Agent 设计中起着关键作用,主要原因有:
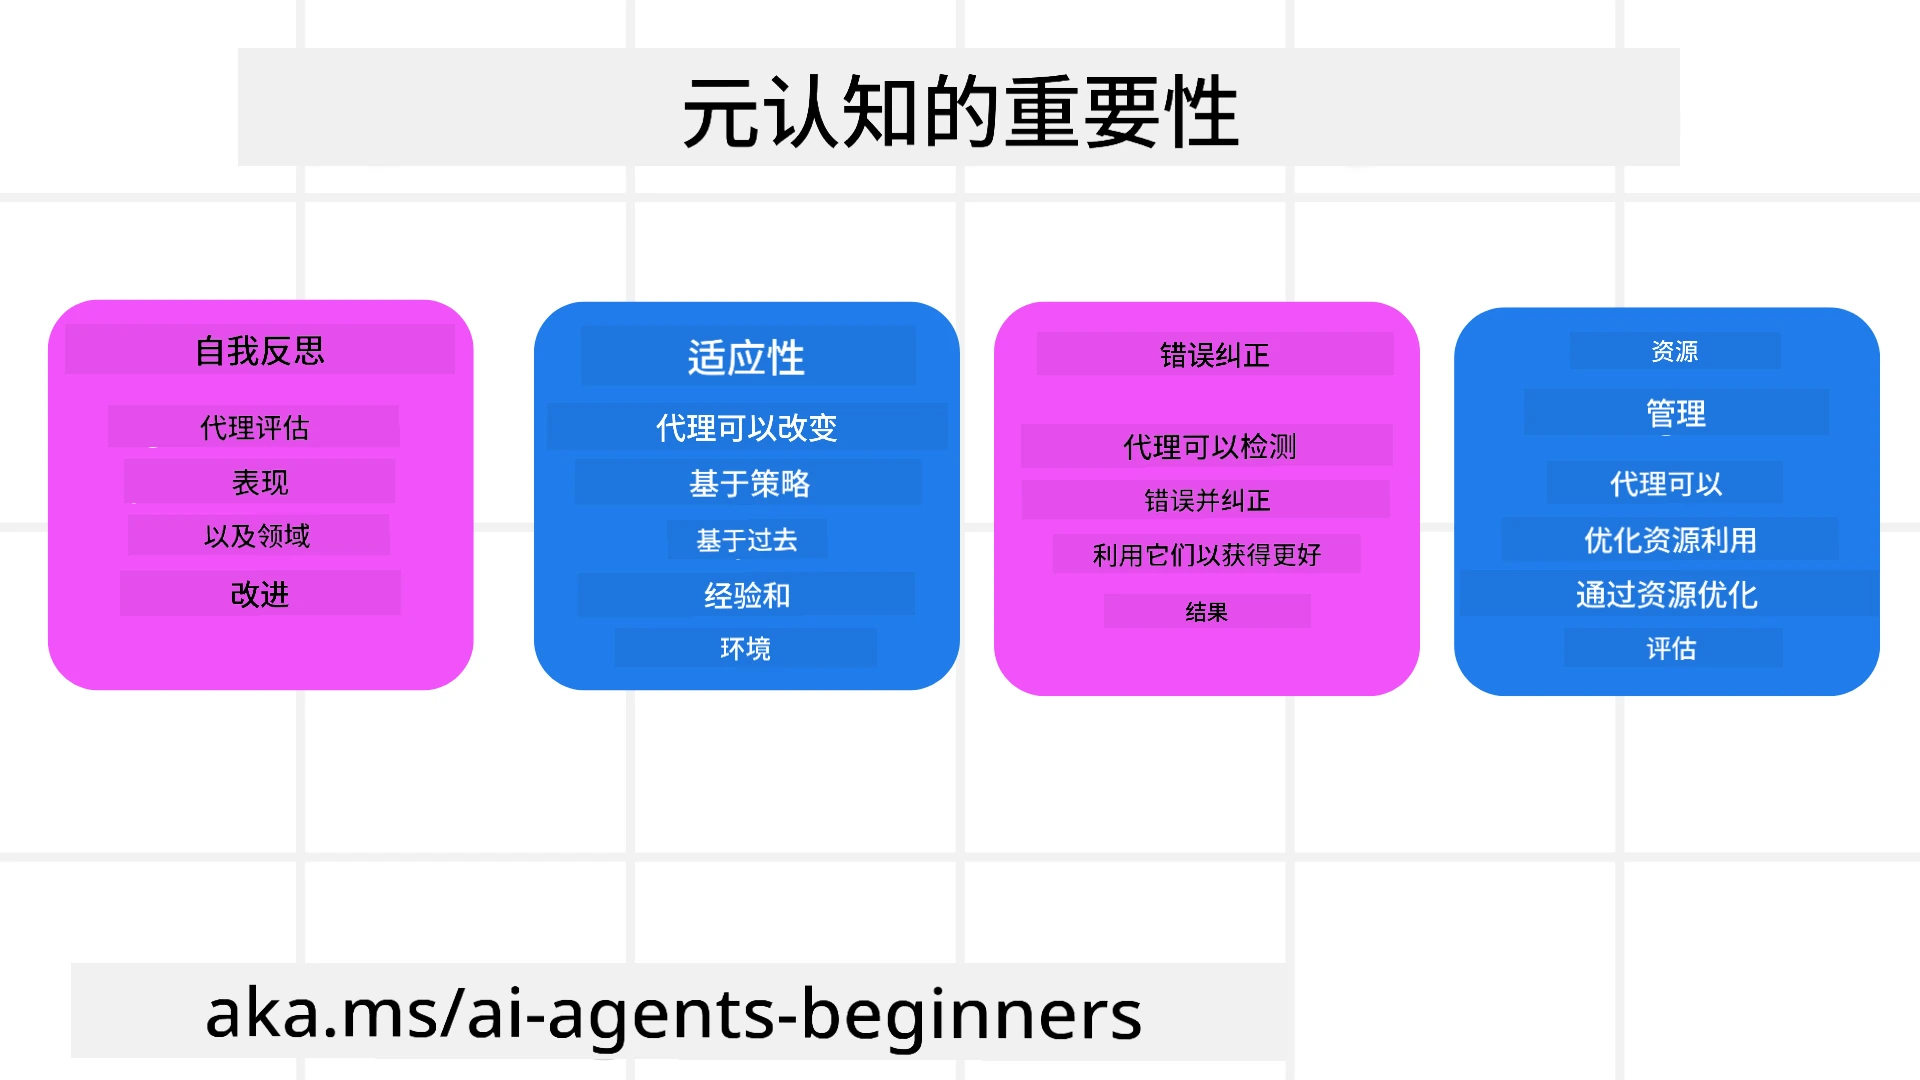
图:元认知重要性。来源:Microsoft AI Agents for Beginners,MIT。
- 自我反思:Agent 可以评估自身表现并识别改进空间。
- 适应能力:Agent 可以根据过去经验和变化环境调整策略。
- 错误修正:Agent 可自主检测并修正错误,提升结果准确性。
- 资源管理:Agent 通过规划和评估优化时间和计算能力等资源的使用。
AI Agent 的组成部分
在深入元认知过程之前,了解 AI Agent 的基本组成部分至关重要。AI Agent 通常包括:
- 角色设定:Agent 的个性及特点,定义其与用户互动的方式。
- 工具:Agent 可执行的功能和能力。
- 技能:Agent 拥有的知识和专长。
这些组成部分协同工作,构成可以执行特定任务的“专业单元”。
示例 : 设想一个旅游 Agent 服务,不仅规划你的假期,还能基于实时数据及过往客户旅程经验调整路径。
示例:旅游 Agent 服务中的元认知
想象你正在设计一个由 AI 驱动的旅游 Agent 服务。该 Agent“旅游 Agent”帮助用户规划假期。为了融入元认知,旅游 Agent 需要基于可观察反馈和历史记录评估并调整行为。元认知可能发挥作用的方式如下:
当前任务
当前任务是帮助用户规划一次巴黎之旅。
完成任务的步骤
- 收集用户偏好 :询问用户的旅行日期、预算、兴趣(如博物馆、美食、购物)及具体需求。
- 检索信息 :搜索符合用户偏好的航班、住宿、景点和餐馆。
- 生成推荐 :提供个性化行程,包括航班详情、酒店预订和建议活动。
- 基于反馈调整 :向用户征求推荐反馈,并据此作出调整。
所需资源
- 访问航班和酒店预订数据库。
- 巴黎景点和餐馆信息。
- 来自先前互动的用户反馈数据。
经验与自我反思
旅游 Agent 利用元认知评估表现并从过往经验中学习。例如:
- 分析用户反馈 :旅游 Agent 审视用户反馈,确定哪些推荐受欢迎,哪些不被认可,进而调整未来建议。
- 适应性 :若用户曾表示不喜欢拥挤场所,旅游 Agent 未来将避免在高峰时段推荐热门景点。
- 错误修正 :若旅游 Agent 曾建议预订已满的酒店,则学会在推荐前更加严格确认可用性。
实际开发者示例
以下是结合元认知的旅游 Agent 简化代码示例:
python
class Travel_Agent:
    def __init__(self):
        self.user_preferences = {}
        self.experience_data = []

    def gather_preferences(self, preferences):
        self.user_preferences = preferences

    def retrieve_information(self):
        # Search for flights, hotels, and attractions based on preferences
        flights = search_flights(self.user_preferences)
        hotels = search_hotels(self.user_preferences)
        attractions = search_attractions(self.user_preferences)
        return flights, hotels, attractions

    def generate_recommendations(self):
        flights, hotels, attractions = self.retrieve_information()
        itinerary = create_itinerary(flights, hotels, attractions)
        return itinerary

    def adjust_based_on_feedback(self, feedback):
        self.experience_data.append(feedback)
        # Analyze feedback and adjust future recommendations
        self.user_preferences = adjust_preferences(self.user_preferences, feedback)

# Example usage
travel_agent = Travel_Agent()
preferences = {
    "destination": "Paris",
    "dates": "2025-04-01 to 2025-04-10",
    "budget": "moderate",
    "interests": ["museums", "cuisine"]
}
travel_agent.gather_preferences(preferences)
itinerary = travel_agent.generate_recommendations()
print("Suggested Itinerary:", itinerary)
feedback = {"liked": ["Louvre Museum"], "disliked": ["Eiffel Tower (too crowded)"]}
travel_agent.adjust_based_on_feedback(feedback)元认知的重要性
- 自我反思 :Agent 可以分析表现并识别改进空间。
- 适应性 :Agent 能根据反馈及环境变化调整策略。
- 错误修正 :Agent 能自主检测并纠正错误。
- 资源管理 :Agent 能优化时间和计算资源的使用。
通过引入元认知,旅游 Agent 能提供更个性化且精准的旅行推荐,提升整体用户体验。
2. Agent 中的规划
规划是 AI Agent 行为的关键组成部分。它涉及制定实现目标所需的步骤,考虑当前状态、资源和可能的障碍。
规划要素
- 当前任务 :明确任务定义。
- 完成任务的步骤 :将任务拆分为可管理的步骤。
- 所需资源 :确定必要资源。
- 经验 :利用过去经验指导规划。
示例 : 以下是旅游 Agent 为有效协助用户制定旅行计划需要采取的步骤:
旅游 Agent 的步骤
收集用户偏好
- 询问用户旅行日期、预算、兴趣及具体需求。
- 示例:“你计划何时出行?”“你的预算范围是多少?”“你假期喜欢什么活动?”
检索信息
- 根据用户偏好搜索相关旅游选项。
- 航班 :寻找预算内且符合偏好的可用航班。
- 住宿 :找到符合用户地点、价格及设施偏好的酒店或租赁房。
- 景点和餐馆 :识别符合用户兴趣的热门景点、活动和餐饮选项。
生成推荐
- 将检索到的信息整合成个性化行程。
- 提供航班选项、酒店预订及建议活动,并确保推荐符合用户偏好。
向用户展示行程
- 将拟议行程分享给用户审阅。
- 示例:“这是为你规划的巴黎旅行建议行程,包括航班详情、酒店预订及推荐活动和餐馆,你怎么看?”
收集反馈
- 征询用户对行程的反馈。
- 示例:“你喜欢这些航班吗?”“酒店合适吗?”“有哪些活动想添加或删除?”
根据反馈调整
- 基于用户反馈修改行程。
- 对航班、住宿及活动建议进行适当调整,以更符合用户偏好。
最终确认
- 向用户展示更新后的行程以供最终确认。
- 示例:“根据你的反馈我已做出调整,这是更新后的行程,你觉得如何?”
预订并确认
- 用户确认后,进行航班、住宿及预定活动的预订。
- 向用户发送确认信息。
持续支持
- 在旅程前后保持支持,协助用户的变更和额外需求。
- 示例:“如果旅行期间需要任何帮助,请随时联系我!”
示例互动
python
class Travel_Agent:
    def __init__(self):
        self.user_preferences = {}
        self.experience_data = []

    def gather_preferences(self, preferences):
        self.user_preferences = preferences

    def retrieve_information(self):
        flights = search_flights(self.user_preferences)
        hotels = search_hotels(self.user_preferences)
        attractions = search_attractions(self.user_preferences)
        return flights, hotels, attractions

    def generate_recommendations(self):
        flights, hotels, attractions = self.retrieve_information()
        itinerary = create_itinerary(flights, hotels, attractions)
        return itinerary

    def adjust_based_on_feedback(self, feedback):
        self.experience_data.append(feedback)
        self.user_preferences = adjust_preferences(self.user_preferences, feedback)

# Example usage within a booing request
travel_agent = Travel_Agent()
preferences = {
    "destination": "Paris",
    "dates": "2025-04-01 to 2025-04-10",
    "budget": "moderate",
    "interests": ["museums", "cuisine"]
}
travel_agent.gather_preferences(preferences)
itinerary = travel_agent.generate_recommendations()
print("Suggested Itinerary:", itinerary)
feedback = {"liked": ["Louvre Museum"], "disliked": ["Eiffel Tower (too crowded)"]}
travel_agent.adjust_based_on_feedback(feedback)3. 纠正性 RAG 系统
首先,让我们理解 RAG 工具和预先上下文加载的区别
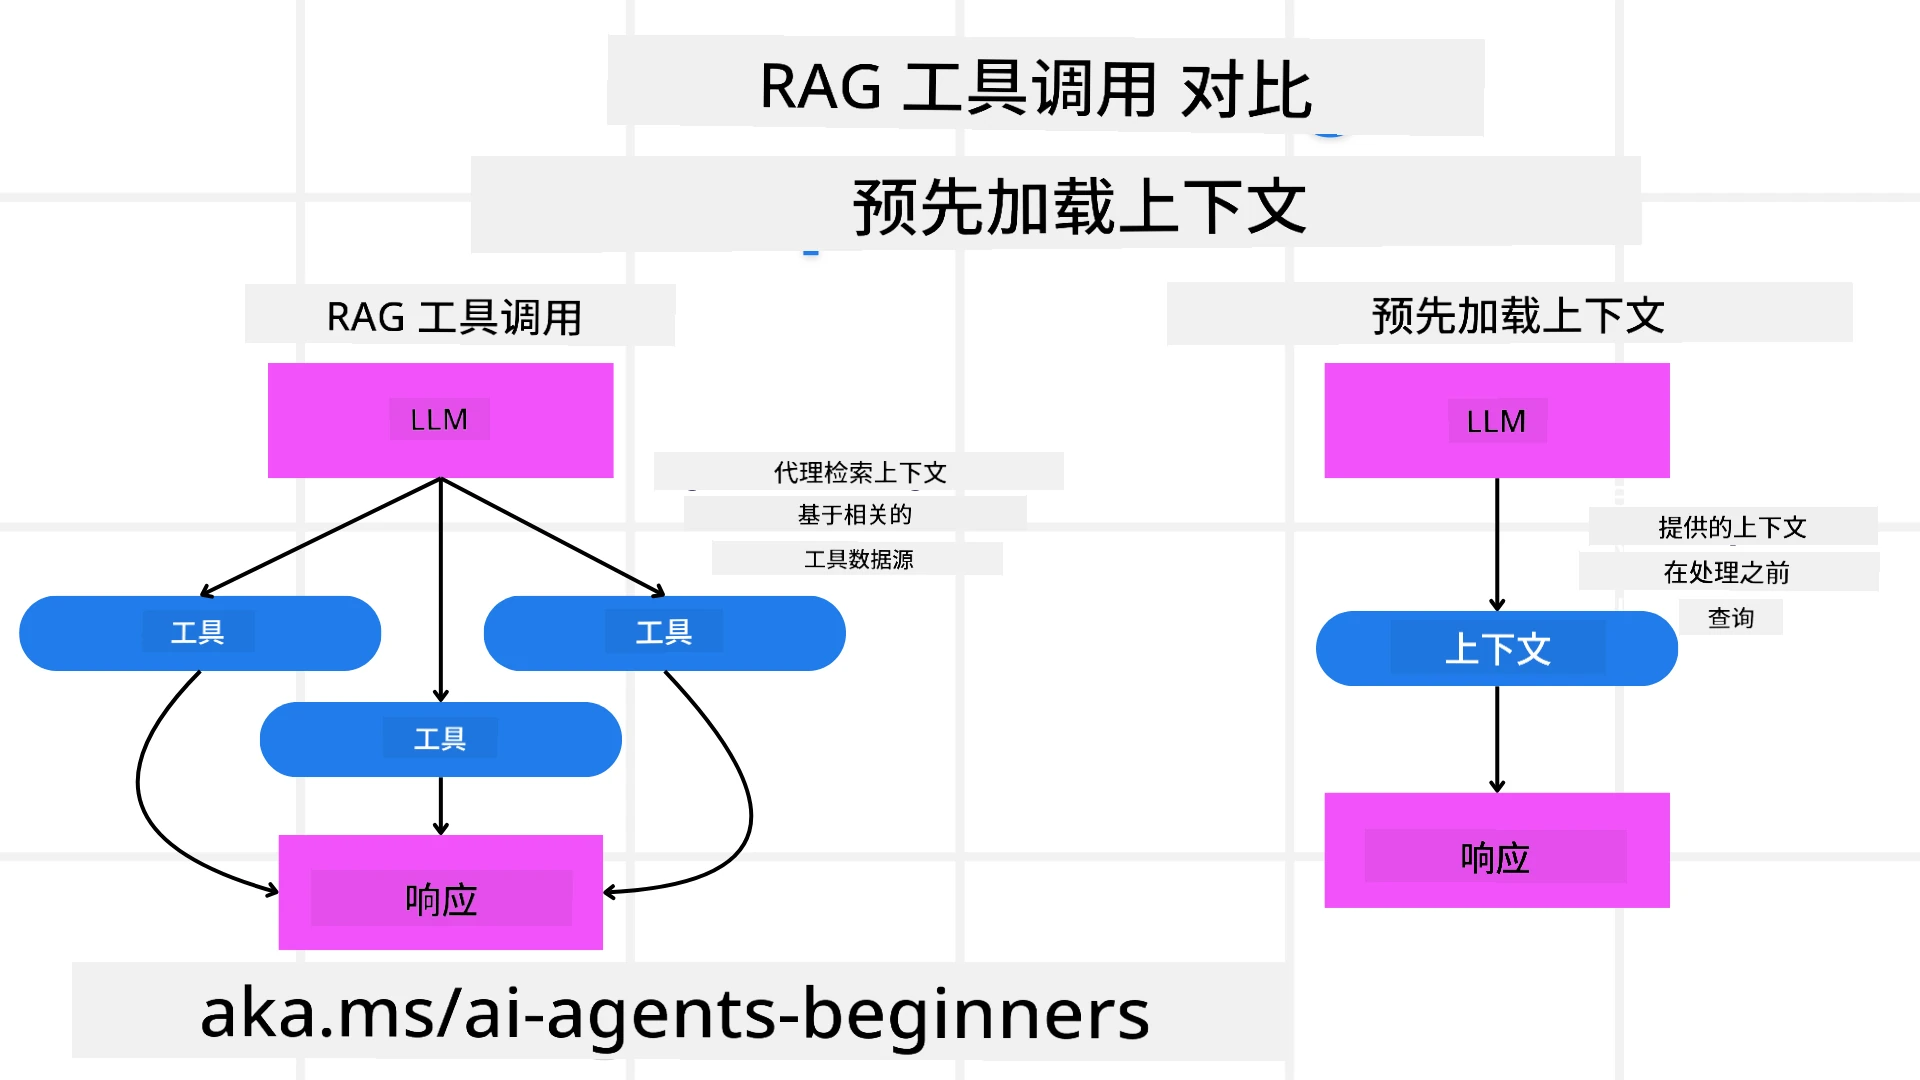
图:RAG 与上下文加载比较。来源:Microsoft AI Agents for Beginners,MIT。
检索增强生成(RAG)
RAG 结合了检索系统和生成模型。当提出查询时,检索系统从外部来源获取相关文档或数据,利用这些检索信息增强生成模型的输入,这帮助模型生成更准确且符合上下文的回复。
在 RAG 系统中,Agent 从知识库检索相关信息,并利用其生成适当的回应或行动。
纠正性 RAG 方法
纠正性 RAG 方法专注于使用 RAG 技术校正错误,提升 AI Agent 的准确度。其包含:
- 提示技术 :使用特定提示引导 Agent 检索相关信息。
- 工具 :实现算法和机制,使 Agent 评估检索信息的相关性并生成准确回复。
- 评估 :持续评估 Agent 表现,并作出调整以提升准确率与效率。
示例:搜索 Agent 中的纠正性 RAG
设想一个从网络检索信息以回答用户查询的搜索 Agent。纠正性 RAG 方法可能包括:
- 提示技术 :基于用户输入制定搜索查询。
- 工具 :利用自然语言处理和机器学习算法对搜索结果进行排序和过滤。
- 评估 :分析用户反馈,识别并纠正检索信息中的不准确之处。
旅游 Agent 中的纠正性 RAG
纠正性 RAG (检索增强生成)增强 AI 检索和生成信息的能力,同时纠正任何不准确之处。让我们看看旅游 Agent 如何利用纠正性 RAG 方法提供更准确且相关的旅行推荐。
包括以下内容:
- 提示技术: 使用特定提示引导 Agent 检索相关信息。
- 工具: 实现算法和机制,使 Agent 评估检索信息相关性并生成准确响应。
- 评估: 持续评估 Agent 表现并作出调整以提升准确率与效率。
在旅游 Agent 中实施纠正性 RAG 的步骤
初始用户互动
旅游 Agent 收集用户初始偏好,如目的地、旅行日期、预算和兴趣。
示例:
pythonpreferences = { "destination": "Paris", "dates": "2025-04-01 to 2025-04-10", "budget": "moderate", "interests": ["museums", "cuisine"] }
信息检索
旅游 Agent 根据用户偏好检索航班、住宿、景点和餐馆信息。
示例:
pythonflights = search_flights(preferences) hotels = search_hotels(preferences) attractions = search_attractions(preferences)
生成初始推荐
旅游 Agent 利用检索信息生成个性化行程。
示例:
pythonitinerary = create_itinerary(flights, hotels, attractions) print("Suggested Itinerary:", itinerary)
收集用户反馈
旅游 Agent 向用户征求对初始推荐的反馈。
示例:
pythonfeedback = { "liked": ["Louvre Museum"], "disliked": ["Eiffel Tower (too crowded)"] }
纠正性 RAG 过程
提示技术 :旅游 Agent 根据用户反馈制定新的搜索查询。
示例:
pythonif "disliked" in feedback: preferences["avoid"] = feedback["disliked"]
工具 :旅游 Agent 使用算法对新搜索结果进行排序和过滤,重点突出根据用户反馈的相关性。
示例:
pythonnew_attractions = search_attractions(preferences) new_itinerary = create_itinerary(flights, hotels, new_attractions) print("Updated Itinerary:", new_itinerary)
评估 :旅游 Agent 不断评估推荐的相关性和准确性,通过分析用户反馈做出必要调整。
示例:
pythondef adjust_preferences(preferences, feedback): if "liked" in feedback: preferences["favorites"] = feedback["liked"] if "disliked" in feedback: preferences["avoid"] = feedback["disliked"] return preferences preferences = adjust_preferences(preferences, feedback)
实际示例
以下是一个简单的 Python 代码示例,整合了旅游 Agent 中的纠正性 RAG 方法:
python
class Travel_Agent:
def __init__(self):
self.user_preferences = {}
self.experience_data = []
def gather_preferences(self, preferences):
self.user_preferences = preferences
def retrieve_information(self):
flights = search_flights(self.user_preferences)
hotels = search_hotels(self.user_preferences)
attractions = search_attractions(self.user_preferences)
return flights, hotels, attractions
def generate_recommendations(self):
flights, hotels, attractions = self.retrieve_information()
itinerary = create_itinerary(flights, hotels, attractions)
return itinerary
def adjust_based_on_feedback(self, feedback):
self.experience_data.append(feedback)
self.user_preferences = adjust_preferences(self.user_preferences, feedback)
new_itinerary = self.generate_recommendations()
return new_itinerary
# Example usage
travel_agent = Travel_Agent()
preferences = {
    "destination": "Paris",
    "dates": "2025-04-01 to 2025-04-10",
    "budget": "moderate",
    "interests": ["museums", "cuisine"]
}
travel_agent.gather_preferences(preferences)
itinerary = travel_agent.generate_recommendations()
print("Suggested Itinerary:", itinerary)
feedback = {"liked": ["Louvre Museum"], "disliked": ["Eiffel Tower (too crowded)"]}
new_itinerary = travel_agent.adjust_based_on_feedback(feedback)
print("Updated Itinerary:", new_itinerary)预先上下文加载
预先加载上下文是指在处理查询之前,将相关的上下文或背景信息加载到模型中。这意味着模型从一开始就可以访问这些信息,从而帮助它生成更有见地的回答,而无需在处理过程中检索额外数据。
下面是一个简化的示例,展示了在 Python 中旅行 Agent 应用如何进行预先加载上下文:
python
class TravelAgent:
def __init__(self):
# Pre-load popular destinations and their information
self.context = {
"Paris": {"country": "France", "currency": "Euro", "language": "French", "attractions": ["Eiffel Tower", "Louvre Museum"]},
"Tokyo": {"country": "Japan", "currency": "Yen", "language": "Japanese", "attractions": ["Tokyo Tower", "Shibuya Crossing"]},
"New York": {"country": "USA", "currency": "Dollar", "language": "English", "attractions": ["Statue of Liberty", "Times Square"]},
"Sydney": {"country": "Australia", "currency": "Dollar", "language": "English", "attractions": ["Sydney Opera House", "Bondi Beach"]}
}
def get_destination_info(self, destination):
# Fetch destination information from pre-loaded context
info = self.context.get(destination)
if info:
return f"{destination}:\nCountry: {info['country']}\nCurrency: {info['currency']}\nLanguage: {info['language']}\nAttractions: {', '.join(info['attractions'])}"
else:
return f"Sorry, we don't have information on {destination}."
# Example usage
travel_agent = TravelAgent()
print(travel_agent.get_destination_info("Paris"))
print(travel_agent.get_destination_info("Tokyo"))说明
初始化(
__init__方法) :TravelAgent类预加载了一个包含热门目的地信息的字典,如巴黎、东京、纽约和悉尼。该字典包括每个目的地的国家、货币、语言和主要景点等详细信息。检索信息(
get_destination_info方法) :当用户查询某个特定目的地时,get_destination_info方法会从预加载的上下文字典中获取相关信息。
通过预先加载上下文,旅行 Agent 应用可以快速响应用户查询,而无需实时从外部来源检索信息。这使应用更加高效和响应迅速。
在迭代前以目标启动计划
以目标启动计划意味着一开始就有一个明确的目标或预期结果。通过事先定义这个目标,模型可以在整个迭代过程中将其作为指导原则。这有助于确保每次迭代都朝着实现预期结果的方向推进,从而使过程更高效、更有针对性。
下面是一个例子,展示了如何在 Python 中为旅行 Agent 在迭代前以目标启动旅行计划:
场景
旅行 Agent 希望为客户规划一个定制的假期。目标是基于客户的偏好和预算创建一个能够最大化客户满意度的旅行行程。
步骤
- 定义客户的偏好和预算。
- 根据这些偏好启动初步计划。
- 通过迭代优化计划,以提高客户满意度。
Python 代码
python
class TravelAgent:
def __init__(self, destinations):
self.destinations = destinations
def bootstrap_plan(self, preferences, budget):
plan = []
total_cost = 0
for destination in self.destinations:
if total_cost + destination['cost'] <= budget and self.match_preferences(destination, preferences):
plan.append(destination)
total_cost += destination['cost']
return plan
def match_preferences(self, destination, preferences):
for key, value in preferences.items():
if destination.get(key) != value:
return False
return True
def iterate_plan(self, plan, preferences, budget):
for i in range(len(plan)):
for destination in self.destinations:
if destination not in plan and self.match_preferences(destination, preferences) and self.calculate_cost(plan, destination) <= budget:
plan[i] = destination
break
return plan
def calculate_cost(self, plan, new_destination):
return sum(destination['cost'] for destination in plan) + new_destination['cost']
# Example usage
destinations = [
{"name": "Paris", "cost": 1000, "activity": "sightseeing"},
{"name": "Tokyo", "cost": 1200, "activity": "shopping"},
{"name": "New York", "cost": 900, "activity": "sightseeing"},
{"name": "Sydney", "cost": 1100, "activity": "beach"},
]
preferences = {"activity": "sightseeing"}
budget = 2000
travel_agent = TravelAgent(destinations)
initial_plan = travel_agent.bootstrap_plan(preferences, budget)
print("Initial Plan:", initial_plan)
refined_plan = travel_agent.iterate_plan(initial_plan, preferences, budget)
print("Refined Plan:", refined_plan)代码说明
初始化(
__init__方法) :TravelAgent类初始化时传入潜在目的地列表,每个目的地有名称、费用和活动类型等属性。启动计划(
bootstrap_plan方法) :该方法根据客户偏好和预算创建初步旅行计划。遍历目的地列表,如果目的地符合客户偏好且预算允许,则加入计划。匹配偏好(
match_preferences方法) :检查某目的地是否符合客户偏好。迭代计划(
iterate_plan方法) :该方法通过尝试用更符合客户偏好和预算约束的替代目的地替换计划中的每个目的地,来优化初步计划。计算费用(
calculate_cost方法) :计算当前计划的总费用,包括可能的新目的地。
示例用法
- 初步计划 :旅行 Agent 根据客户对观光的偏好和 2000 美元的预算创建初步计划。
- 优化计划 :旅行 Agent 迭代优化该计划,以更好地满足客户偏好和预算。
通过以明确目标(例如最大化客户满意度)启动计划并通过迭代优化,旅行 Agent 可以为客户创建定制且优化的旅行行程。这种方法确保旅行计划从一开始就符合客户的偏好和预算,并能随着每次迭代不断改进。
利用大语言模型进行重排和评分
大语言模型(LLM)可以用于重排和评分,通过评估检索到的文档或生成回答的相关性和质量。其工作原理如下:
检索: 初步检索步骤根据查询获取候选文档或回答集合。
重排: LLM 评估这些候选项,并根据相关性和质量进行重排。此步骤确保最相关且高质量的信息优先呈现。
评分: LLM 给每个候选项赋分,反映其相关性和质量。这有助于选择最佳回答或文档。
通过利用 LLM 进行重排和评分,系统可以提供更准确、更符合上下文的信息,提高整体用户体验。
以下示例展示了旅行 Agent 如何在 Python 中利用大语言模型(LLM)基于用户偏好对旅行目的地进行重排和评分:
场景 - 基于偏好的旅行
旅行 Agent 希望根据客户偏好推荐最佳旅行目的地。LLM 帮助对目的地进行重排和评分,确保呈现最相关选项。
步骤:
- 收集用户偏好。
- 检索潜在旅行目的地列表。
- 使用 LLM 根据用户偏好对目的地进行重排和评分。
下面展示如何将之前的示例更新为使用 Azure OpenAI 服务:
要求
- 需要拥有 Azure 订阅。
- 创建 Azure OpenAI 资源并获取 API 密钥。
示例 Python 代码
python
import requests
import json
class TravelAgent:
def __init__(self, destinations):
self.destinations = destinations
def get_recommendations(self, preferences, api_key, endpoint):
# Generate a prompt for the Azure OpenAI
prompt = self.generate_prompt(preferences)
# Define headers and payload for the request
headers = {
'Content-Type': 'application/json',
'Authorization': f'Bearer {api_key}'
}
payload = {
"prompt": prompt,
"max_tokens": 150,
"temperature": 0.7
}
# Call the Azure OpenAI API to get the re-ranked and scored destinations
response = requests.post(endpoint, headers=headers, json=payload)
response_data = response.json()
# Extract and return the recommendations
recommendations = response_data['choices'][0]['text'].strip().split('\n')
return recommendations
def generate_prompt(self, preferences):
prompt = "Here are the travel destinations ranked and scored based on the following user preferences:\n"
for key, value in preferences.items():
prompt += f"{key}: {value}\n"
prompt += "\nDestinations:\n"
for destination in self.destinations:
prompt += f"- {destination['name']}: {destination['description']}\n"
return prompt
# Example usage
destinations = [
{"name": "Paris", "description": "City of lights, known for its art, fashion, and culture."},
{"name": "Tokyo", "description": "Vibrant city, famous for its modernity and traditional temples."},
{"name": "New York", "description": "The city that never sleeps, with iconic landmarks and diverse culture."},
{"name": "Sydney", "description": "Beautiful harbour city, known for its opera house and stunning beaches."},
]
preferences = {"activity": "sightseeing", "culture": "diverse"}
api_key = 'your_azure_openai_api_key'
endpoint = 'https://your-endpoint.com/openai/deployments/your-deployment-name/completions?api-version=2022-12-01'
travel_agent = TravelAgent(destinations)
recommendations = travel_agent.get_recommendations(preferences, api_key, endpoint)
print("Recommended Destinations:")
for rec in recommendations:
print(rec)代码说明 - 偏好订购者
初始化 :
TravelAgent类初始化时传入潜在旅行目的地列表,每个目的地有名称和描述等属性。获取推荐 (
get_recommendations方法) :该方法基于用户偏好生成 Azure OpenAI 服务的提示词,并向 Azure OpenAI API 发起 HTTP POST 请求,获取重排和评分后的目的地列表。生成提示词 (
generate_prompt方法) :该方法构造 Azure OpenAI 所需的提示词,包含用户偏好和目的地列表,引导模型根据给定偏好对目的地进行重排和评分。API 调用 :利用
requests库向 Azure OpenAI API 端点发起 HTTP POST 请求,响应包含重排和评分后的目的地数据。示例用法 :旅行 Agent 收集用户偏好(例如对观光和多元文化的兴趣),使用 Azure OpenAI 服务获取重排和评分后的旅行推荐。
此处 URL 与密钥字符串是历史示意占位符,不是可运行配置。真实实验应通过本地环境变量加载凭据,并按当前所用 SDK 版本构造端点;不要将真实密钥填入正文或提交到代码仓库。
通过利用 LLM 进行重排和评分,旅行 Agent 能够为客户提供更个性化和相关的旅行推荐,提升整体体验。
RAG:提示技术 与 工具
检索增强生成(RAG)既可以是一种提示技术,也可以是开发 AI Agent 的一个工具。理解两者之间的区别,有助于更有效地在项目中利用 RAG。
作为提示技术的 RAG
它是什么?
- 作为提示技术,RAG 涉及设计特定查询或提示,引导从大规模语料库或数据库检索相关信息。然后利用这些信息生成回答或执行操作。
工作原理:
- 设计提示 :根据任务或用户输入创建结构化提示或查询。
- 检索信息 :利用提示,从已有知识库或数据集中检索相关数据。
- 生成回答 :结合检索到的信息和生成式 AI 模型,产出全面且连贯的回答。
旅行 Agent 示例 :
- 用户输入:“我想参观巴黎的博物馆。”
- 提示:“查找巴黎的顶级博物馆。”
- 检索信息:关于卢浮宫博物馆、奥赛博物馆等的详细信息。
- 生成回答:“以下是巴黎的一些顶级博物馆:卢浮宫博物馆、奥赛博物馆和蓬皮杜艺术中心。”
作为工具的 RAG
它是什么?
- 作为工具,RAG 是一个集成系统,自动化检索和生成流程,使开发者无需为每个查询手工编写提示,即可轻松实现复杂 AI 功能。
工作原理:
- 集成 :将 RAG 嵌入 AI Agent 架构,自动处理检索和生成任务。
- 自动化 :工具管理整个流程,从接收用户输入到生成最终回答,无需每步显式提示。
- 效率提升 :通过简化检索和生成过程,提升 Agent 性能,实现更快更精准的响应。
旅行 Agent 示例 :
- 用户输入:“我想参观巴黎的博物馆。”
- RAG 工具:自动检索关于博物馆的信息并生成回答。
- 生成回答:“以下是巴黎的一些顶级博物馆:卢浮宫博物馆、奥赛博物馆和蓬皮杜艺术中心。”
对比
| 方面 | 提示技术 | 工具 |
|---|---|---|
| 手动 vs 自动 | 每个查询手动设计提示 | 检索和生成全过程自动化 |
| 控制力 | 对检索流程有更大控制 | 简化并自动化检索和生成 |
| 灵活性 | 可基于特定需求定制提示 | 更适合大规模部署 |
| 复杂度 | 需设计和调整提示 | 易于集成到 AI Agent 架构中 |
实践示例
提示技术示例:
python
def search_museums_in_paris():
prompt = "Find top museums in Paris"
search_results = search_web(prompt)
return search_results
museums = search_museums_in_paris()
print("Top Museums in Paris:", museums)工具示例:
python
class Travel_Agent:
def __init__(self):
self.rag_tool = RAGTool()
def get_museums_in_paris(self):
user_input = "I want to visit museums in Paris."
response = self.rag_tool.retrieve_and_generate(user_input)
return response
travel_agent = Travel_Agent()
museums = travel_agent.get_museums_in_paris()
print("Top Museums in Paris:", museums)评估相关性
评估相关性是 AI Agent 性能的重要方面。它确保 Agent 检索和生成的信息对用户是恰当、准确且有用的。下面探讨评估相关性的方式,包括实际例子和技术。
评估相关性的关键概念
上下文意识 :
- Agent 必须理解用户查询的上下文,才能检索并生成相关信息。
- 例如:用户询问“巴黎最好的餐厅”,Agent 应考虑用户对菜系类型和预算的偏好。
准确性 :
- Agent 提供的信息应为事实正确且最新的。
- 例如:推荐当前营业且评价良好的餐厅,而非过时或已关闭的选项。
用户意图 :
- Agent 应推断用户查询背后的意图,提供最相关信息。
- 例如:用户查询“经济型酒店”,Agent 应优先推荐价格实惠的选项。
反馈循环 :
- 持续收集和分析用户反馈,帮助 Agent 优化相关性评估过程。
- 例如:根据用户对之前推荐的评分和反馈,改进后续回答。
评估相关性的实用技术
相关性评分 :
根据检索项与用户查询及偏好的匹配程度,为每项赋予相关性评分。
例如:
pythondef relevance_score(item, query): score = 0 if item['category'] in query['interests']: score += 1 if item['price'] <= query['budget']: score += 1 if item['location'] == query['destination']: score += 1 return score
过滤与排序 :
过滤掉无关项,并根据相关性评分对剩余项排序。
例如:
pythondef filter_and_rank(items, query): ranked_items = sorted(items, key=lambda item: relevance_score(item, query), reverse=True) return ranked_items[:10] # Return top 10 relevant items
自然语言处理(NLP) :
利用 NLP 技术理解用户查询,检索相关信息。
例如:
pythondef process_query(query): # Use NLP to extract key information from the user's query processed_query = nlp(query) return processed_query
用户反馈整合 :
收集对提供推荐的用户反馈,并用于调整未来的相关性评估。
例如:
pythondef adjust_based_on_feedback(feedback, items): for item in items: if item['name'] in feedback['liked']: item['relevance'] += 1 if item['name'] in feedback['disliked']: item['relevance'] -= 1 return items
示例:旅行 Agent 中的相关性评估
下面是旅行 Agent 如何评估旅行推荐相关性的实际示例:
python
class Travel_Agent:
def __init__(self):
self.user_preferences = {}
self.experience_data = []
def gather_preferences(self, preferences):
self.user_preferences = preferences
def retrieve_information(self):
flights = search_flights(self.user_preferences)
hotels = search_hotels(self.user_preferences)
attractions = search_attractions(self.user_preferences)
return flights, hotels, attractions
def generate_recommendations(self):
flights, hotels, attractions = self.retrieve_information()
ranked_hotels = self.filter_and_rank(hotels, self.user_preferences)
itinerary = create_itinerary(flights, ranked_hotels, attractions)
return itinerary
def filter_and_rank(self, items, query):
ranked_items = sorted(items, key=lambda item: self.relevance_score(item, query), reverse=True)
return ranked_items[:10] # Return top 10 relevant items
def relevance_score(self, item, query):
score = 0
if item['category'] in query['interests']:
score += 1
if item['price'] <= query['budget']:
score += 1
if item['location'] == query['destination']:
score += 1
return score
def adjust_based_on_feedback(self, feedback, items):
for item in items:
if item['name'] in feedback['liked']:
item['relevance'] += 1
if item['name'] in feedback['disliked']:
item['relevance'] -= 1
return items
# Example usage
travel_agent = Travel_Agent()
preferences = {
"destination": "Paris",
"dates": "2025-04-01 to 2025-04-10",
"budget": "moderate",
"interests": ["museums", "cuisine"]
}
travel_agent.gather_preferences(preferences)
itinerary = travel_agent.generate_recommendations()
print("Suggested Itinerary:", itinerary)
feedback = {"liked": ["Louvre Museum"], "disliked": ["Eiffel Tower (too crowded)"]}
updated_items = travel_agent.adjust_based_on_feedback(feedback, itinerary['hotels'])
print("Updated Itinerary with Feedback:", updated_items)带有意图的搜索
带有意图的搜索涉及理解和解析用户查询背后的真实目的或目标,以检索和生成最相关且有用的信息。这种方法超越了简单的关键词匹配,更关注把握用户的实际需求和上下文。
带有意图搜索的关键概念
理解用户意图 :
- 用户意图可分为三类:信息性、导航性和交易性。
- 信息性意图 :用户寻求某个主题的信息(如“巴黎有哪些最好博物馆?”)。
- 导航性意图 :用户想访问特定网站或页面(如“卢浮宫博物馆官网”)。
- 交易性意图 :用户希望完成交易,如预订机票或购买商品(如“预订飞往巴黎的机票”)。
- 用户意图可分为三类:信息性、导航性和交易性。
上下文意识 :
- 分析用户查询的上下文,有助于准确识别用户意图。这包括考虑之前交互、用户偏好和当前查询的具体细节。
自然语言处理(NLP) :
- 利用 NLP 技术理解和解析用户的自然语言查询,包括实体识别、情感分析和查询解析等任务。
个性化 :
- 基于用户历史、偏好和反馈对搜索结果进行个性化,提高检索信息的相关性。
实用示例:旅行 Agent 中的带有意图搜索
以旅行 Agent 为例,看看如何实现带有意图的搜索。
收集用户偏好
pythonclass Travel_Agent: def __init__(self): self.user_preferences = {} def gather_preferences(self, preferences): self.user_preferences = preferences理解用户意图
pythondef identify_intent(query): if "book" in query or "purchase" in query: return "transactional" elif "website" in query or "official" in query: return "navigational" else: return "informational"上下文意识
pythondef analyze_context(query, user_history): # Combine current query with user history to understand context context = { "current_query": query, "user_history": user_history } return context搜索和个性化结果
pythondef search_with_intent(query, preferences, user_history): intent = identify_intent(query) context = analyze_context(query, user_history) if intent == "informational": search_results = search_information(query, preferences) elif intent == "navigational": search_results = search_navigation(query) elif intent == "transactional": search_results = search_transaction(query, preferences) personalized_results = personalize_results(search_results, user_history) return personalized_results def search_information(query, preferences): # Example search logic for informational intent results = search_web(f"best {preferences['interests']} in {preferences['destination']}") return results def search_navigation(query): # Example search logic for navigational intent results = search_web(query) return results def search_transaction(query, preferences): # Example search logic for transactional intent results = search_web(f"book {query} to {preferences['destination']}") return results def personalize_results(results, user_history): # Example personalization logic personalized = [result for result in results if result not in user_history] return personalized[:10] # Return top 10 personalized results示例用法
pythontravel_agent = Travel_Agent() preferences = { "destination": "Paris", "interests": ["museums", "cuisine"] } travel_agent.gather_preferences(preferences) user_history = ["Louvre Museum website", "Book flight to Paris"] query = "best museums in Paris" results = search_with_intent(query, preferences, user_history) print("Search Results:", results)
4. 将代码生成作为工具
代码生成 Agent 使用 AI 模型编写和执行代码,以解决复杂问题和自动化任务。
代码生成 Agent
代码生成 Agent 使用生成式 AI 模型来编写和执行代码。这些 Agent 可以通过生成和运行各种编程语言的代码来解决复杂问题、自动化任务并提供有价值的洞见。
实际应用
- 自动代码生成 :为特定任务生成代码段,如数据分析、网页爬取或机器学习。
- 将 SQL 用作 RAG :使用 SQL 查询从数据库检索和操作数据。
- 问题解决 :创建并执行代码以解决具体问题,如优化算法或分析数据。
示例:用于数据分析的代码生成 Agent
假设你正在设计一个代码生成 Agent。它的工作流程可能如下:
- 任务 :分析数据集以识别趋势和模式。
- 步骤 :
- 将数据集加载到数据分析工具中。
- 生成 SQL 查询以过滤和聚合数据。
- 执行查询并获取结果。
- 使用结果生成可视化和洞见。
- 所需资源 :访问数据集、数据分析工具和 SQL 能力。
- 经验 :利用过去的分析结果提高未来分析的准确性和相关性。
示例:用于旅行 Agent 的代码生成 Agent
在此示例中,我们将设计一个代码生成 Agent Travel Agent,帮助用户通过生成和执行代码来规划旅行。该 Agent 可以处理获取旅行选项、筛选结果和使用生成式 AI 编制行程等任务。
代码生成 Agent 概览
- 收集用户偏好 :收集用户输入,如目的地、旅行日期、预算和兴趣。
- 生成代码以获取数据 :生成代码片段检索航班、酒店和景点信息。
- 执行生成的代码 :运行生成的代码以获取实时信息。
- 生成行程 :将获取的数据编制成个性化旅行计划。
- 根据反馈调整 :接收用户反馈,必要时重新生成代码以优化结果。
逐步实现
收集用户偏好
pythonclass Travel_Agent: def __init__(self): self.user_preferences = {} def gather_preferences(self, preferences): self.user_preferences = preferences生成代码以获取数据
pythondef generate_code_to_fetch_data(preferences): # Example: Generate code to search for flights based on user preferences code = f""" def search_flights(): import requests response = requests.get('https://api.example.com/flights', params={preferences}) return response.json() """ return code def generate_code_to_fetch_hotels(preferences): # Example: Generate code to search for hotels code = f""" def search_hotels(): import requests response = requests.get('https://api.example.com/hotels', params={preferences}) return response.json() """ return code执行生成的代码
pythondef execute_code(code): # Execute the generated code using exec exec(code) result = locals() return result travel_agent = Travel_Agent() preferences = { "destination": "Paris", "dates": "2025-04-01 to 2025-04-10", "budget": "moderate", "interests": ["museums", "cuisine"] } travel_agent.gather_preferences(preferences) flight_code = generate_code_to_fetch_data(preferences) hotel_code = generate_code_to_fetch_hotels(preferences) flights = execute_code(flight_code) hotels = execute_code(hotel_code) print("Flight Options:", flights) print("Hotel Options:", hotels)生成行程
pythondef generate_itinerary(flights, hotels, attractions): itinerary = { "flights": flights, "hotels": hotels, "attractions": attractions } return itinerary attractions = search_attractions(preferences) itinerary = generate_itinerary(flights, hotels, attractions) print("Suggested Itinerary:", itinerary)根据反馈调整
pythondef adjust_based_on_feedback(feedback, preferences): # Adjust preferences based on user feedback if "liked" in feedback: preferences["favorites"] = feedback["liked"] if "disliked" in feedback: preferences["avoid"] = feedback["disliked"] return preferences feedback = {"liked": ["Louvre Museum"], "disliked": ["Eiffel Tower (too crowded)"]} updated_preferences = adjust_based_on_feedback(feedback, preferences) # Regenerate and execute code with updated preferences updated_flight_code = generate_code_to_fetch_data(updated_preferences) updated_hotel_code = generate_code_to_fetch_hotels(updated_preferences) updated_flights = execute_code(updated_flight_code) updated_hotels = execute_code(updated_hotel_code) updated_itinerary = generate_itinerary(updated_flights, updated_hotels, attractions) print("Updated Itinerary:", updated_itinerary)
利用环境感知与推理
基于表格的模式确实可以通过利用环境感知与推理来增强查询生成过程。
下面是一个示例说明如何实现:
- 理解模式 :系统将理解表格的模式,并使用这些信息为查询生成提供基础。
- 基于反馈调整 :系统将根据反馈调整用户偏好,并推理哪些模式字段需要更新。
- 生成并执行查询 :系统将生成并执行查询,根据新偏好获取更新的航班和酒店数据。
这是一个结合上述概念的更新 Python 代码示例:
python
def adjust_based_on_feedback(feedback, preferences, schema):
# Adjust preferences based on user feedback
if "liked" in feedback:
preferences["favorites"] = feedback["liked"]
if "disliked" in feedback:
    preferences["avoid"] = feedback["disliked"]
# Reasoning based on schema to adjust other related preferences
for field in schema:
if field in preferences:
preferences[field] = adjust_based_on_environment(feedback, field, schema)
return preferences
def adjust_based_on_environment(feedback, field, schema):
# Custom logic to adjust preferences based on schema and feedback
if field in feedback["liked"]:
return schema[field]["positive_adjustment"]
elif field in feedback["disliked"]:
return schema[field]["negative_adjustment"]
return schema[field]["default"]
def generate_code_to_fetch_data(preferences):
# Generate code to fetch flight data based on updated preferences
return f"fetch_flights(preferences={preferences})"
def generate_code_to_fetch_hotels(preferences):
# Generate code to fetch hotel data based on updated preferences
return f"fetch_hotels(preferences={preferences})"
def execute_code(code):
# Simulate execution of code and return mock data
return {"data": f"Executed: {code}"}
def generate_itinerary(flights, hotels, attractions):
# Generate itinerary based on flights, hotels, and attractions
return {"flights": flights, "hotels": hotels, "attractions": attractions}
# Example schema
schema = {
"favorites": {"positive_adjustment": "increase", "negative_adjustment": "decrease", "default": "neutral"},
"avoid": {"positive_adjustment": "decrease", "negative_adjustment": "increase", "default": "neutral"}
}
# Example usage
preferences = {"favorites": "sightseeing", "avoid": "crowded places"}
feedback = {"liked": ["Louvre Museum"], "disliked": ["Eiffel Tower (too crowded)"]}
updated_preferences = adjust_based_on_feedback(feedback, preferences, schema)
# Regenerate and execute code with updated preferences
updated_flight_code = generate_code_to_fetch_data(updated_preferences)
updated_hotel_code = generate_code_to_fetch_hotels(updated_preferences)
updated_flights = execute_code(updated_flight_code)
updated_hotels = execute_code(updated_hotel_code)
updated_itinerary = generate_itinerary(updated_flights, updated_hotels, feedback["liked"])
print("Updated Itinerary:", updated_itinerary)说明 - 基于反馈的预订
- 模式感知 :
schema字典定义了基于反馈如何调整偏好,包括favorites和avoid等字段及其对应调整。 - 调整偏好(
adjust_based_on_feedback方法) :此方法根据用户反馈和模式调整偏好。 - 基于环境的调整(
adjust_based_on_environment方法) :该方法根据模式和反馈定制调整。 - 生成并执行查询 :系统生成代码以基于调整后的偏好获取更新的航班和酒店数据,并模拟执行这些查询。
- 生成行程 :系统基于新的航班、酒店和景点数据创建更新后的行程。
通过使系统具备环境感知能力并基于模式进行推理,它能生成更准确、更相关的查询,从而提供更好的旅行推荐和更个性化的用户体验。
使用 SQL 作为检索增强生成(RAG)技术
SQL(结构化查询语言)是与数据库交互的强大工具。在作为检索增强生成(RAG)方法一部分时,SQL 能从数据库中检索相关数据以支持并生成 AI Agent 的响应或动作。让我们探讨如何在旅行 Agent 中将 SQL 用作 RAG 技术。
关键概念
数据库交互 :
- 使用 SQL 查询数据库,检索相关信息并操作数据。
- 例如:从旅行数据库获取航班详情、酒店信息和景点数据。
与 RAG 集成 :
- 根据用户输入和偏好生成 SQL 查询。
- 利用检索到的数据生成个性化推荐或操作。
动态查询生成 :
- AI Agent 根据上下文和用户需求生成动态 SQL 查询。
- 例如:定制 SQL 查询以根据预算、日期和兴趣筛选结果。
应用场景
- 自动代码生成 :为特定任务生成代码片段。
- 将 SQL 用作 RAG :利用 SQL 查询操作数据。
- 问题解决 :创建并执行代码解决问题。
示例 : 一个数据分析 Agent:
- 任务 :分析数据集找出趋势。
- 步骤 :
- 加载数据集。
- 生成 SQL 查询过滤数据。
- 执行查询并获取结果。
- 生成可视化和洞见。
- 资源 :数据访问权限,SQL 能力。
- 经验 :利用过去结果提升未来分析效果。
实际示例:在旅行 Agent 中使用 SQL
收集用户偏好
pythonclass Travel_Agent: def __init__(self): self.user_preferences = {} def gather_preferences(self, preferences): self.user_preferences = preferences生成 SQL 查询
pythondef generate_sql_query(table, preferences): query = f"SELECT * FROM {table} WHERE " conditions = [] for key, value in preferences.items(): conditions.append(f"{key}='{value}'") query += " AND ".join(conditions) return query执行 SQL 查询
pythonimport sqlite3 def execute_sql_query(query, database="travel.db"): connection = sqlite3.connect(database) cursor = connection.cursor() cursor.execute(query) results = cursor.fetchall() connection.close() return results生成推荐
pythondef generate_recommendations(preferences): flight_query = generate_sql_query("flights", preferences) hotel_query = generate_sql_query("hotels", preferences) attraction_query = generate_sql_query("attractions", preferences) flights = execute_sql_query(flight_query) hotels = execute_sql_query(hotel_query) attractions = execute_sql_query(attraction_query) itinerary = { "flights": flights, "hotels": hotels, "attractions": attractions } return itinerary travel_agent = Travel_Agent() preferences = { "destination": "Paris", "dates": "2025-04-01 to 2025-04-10", "budget": "moderate", "interests": ["museums", "cuisine"] } travel_agent.gather_preferences(preferences) itinerary = generate_recommendations(preferences) print("Suggested Itinerary:", itinerary)
示例 SQL 查询
航班查询
sqlSELECT * FROM flights WHERE destination='Paris' AND dates='2025-04-01 to 2025-04-10' AND budget='moderate';酒店查询
sqlSELECT * FROM hotels WHERE destination='Paris' AND budget='moderate';景点查询
sqlSELECT * FROM attractions WHERE destination='Paris' AND interests='museums, cuisine';
通过利用 SQL 作为检索增强生成(RAG)技术的一部分,像旅行 Agent 这样的 AI Agent 可以动态检索并使用相关数据,从而提供准确且个性化的推荐。
元认知示例
为了演示元认知的实现,创建一个简单的 Agent,其 在解决问题时反思自身的决策过程 。在此示例中,我们构建一个系统,Agent 试图优化酒店选择,但当犯错或做出次优选择时,会评估自身推理并调整策略。
我们将通过一个基本示例模拟该过程,Agent 基于价格和质量组合选择酒店,但会“反思”其决策并据此调整。
这展示了元认知的方式:
- 初始决策 :Agent 将选择最便宜的酒店,未考虑质量影响。
- 反思和评估 :初次选择后,Agent 根据用户反馈检查酒店是否是“差”选择。如果发现质量过低,它会反思其推理。
- 调整策略 :Agent 根据反思调整策略,从“最便宜”调整为“最高质量”,从而改善未来迭代的决策过程。
示例代码如下:
python
class HotelRecommendationAgent:
    def __init__(self):
        self.previous_choices = []  # Stores the hotels chosen previously
        self.corrected_choices = []  # Stores the corrected choices
        self.recommendation_strategies = ['cheapest', 'highest_quality']  # Available strategies

    def recommend_hotel(self, hotels, strategy):
        """
        Recommend a hotel based on the chosen strategy.
        The strategy can either be 'cheapest' or 'highest_quality'.
        """
        if strategy == 'cheapest':
            recommended = min(hotels, key=lambda x: x['price'])
        elif strategy == 'highest_quality':
            recommended = max(hotels, key=lambda x: x['quality'])
        else:
            recommended = None
        self.previous_choices.append((strategy, recommended))
        return recommended

    def reflect_on_choice(self):
        """
        Reflect on the last choice made and decide if the agent should adjust its strategy.
        The agent considers if the previous choice led to a poor outcome.
        """
        if not self.previous_choices:
            return "No choices made yet."

        last_choice_strategy, last_choice = self.previous_choices[-1]
        # Let's assume we have some user feedback that tells us whether the last choice was good or not
        user_feedback = self.get_user_feedback(last_choice)

        if user_feedback == "bad":
            # Adjust strategy if the previous choice was unsatisfactory
            new_strategy = 'highest_quality' if last_choice_strategy == 'cheapest' else 'cheapest'
            self.corrected_choices.append((new_strategy, last_choice))
            return f"Reflecting on choice. Adjusting strategy to {new_strategy}."
        else:
            return "The choice was good. No need to adjust."

    def get_user_feedback(self, hotel):
        """
        Simulate user feedback based on hotel attributes.
        For simplicity, assume if the hotel is too cheap, the feedback is "bad".
        If the hotel has quality less than 7, feedback is "bad".
        """
        if hotel['price'] < 100 or hotel['quality'] < 7:
            return "bad"
        return "good"

# Simulate a list of hotels (price and quality)
hotels = [
    {'name': 'Budget Inn', 'price': 80, 'quality': 6},
    {'name': 'Comfort Suites', 'price': 120, 'quality': 8},
    {'name': 'Luxury Stay', 'price': 200, 'quality': 9}
]

# Create an agent
agent = HotelRecommendationAgent()

# Step 1: The agent recommends a hotel using the "cheapest" strategy
recommended_hotel = agent.recommend_hotel(hotels, 'cheapest')
print(f"Recommended hotel (cheapest): {recommended_hotel['name']}")

# Step 2: The agent reflects on the choice and adjusts strategy if necessary
reflection_result = agent.reflect_on_choice()
print(reflection_result)

# Step 3: The agent recommends again, this time using the adjusted strategy
adjusted_recommendation = agent.recommend_hotel(hotels, 'highest_quality')
print(f"Adjusted hotel recommendation (highest_quality): {adjusted_recommendation['name']}")Agent 的元认知能力
关键在于 Agent 能够:
- 评估其之前的选择和决策过程。
- 基于该反思调整策略,即元认知的实际应用。
这是一种简单形式的元认知,系统能基于检查结果调整下一步策略。
结论
元认知是一个强大的工具,可显著提升 AI Agent 的能力。通过引入元认知过程,你可以设计出更加智能、适应性强且高效的 Agent。利用附加资源进一步探索 AI Agent 中令人着迷的元认知世界。
把全章串成一项任务(补充讲解)
目标是“周末住两晚,总预算 1500 元,评分至少 4.5”。先加载日期、人数和预算作为初始上下文;规划器产生查酒店→过滤→比较→解释的计划。检索器返回酒店数据,检查器检查字段是否齐全、价格单位是否一致、总价是否含两晚。证据不相关则改写查询,信息不足则询问用户,不能自行编造税费。
| 原课程技术 | 这个案例中的作用 | 边界 |
|---|---|---|
| 纠错 RAG(Corrective RAG) | 发现返回的是景点后重新查酒店 | 重试必须有次数上限 |
| 预先加载上下文 | 在搜索前放入日期和人数 | 过期偏好不能覆盖本次要求 |
| 目标驱动的初始规划 | 把预算条件带入所有子任务 | 有计划不表示任务已完成 |
| 重排与评分(Re-ranking) | 先硬过滤,再比较价格和评分 | 模型评分不是概率,也不是事实校验 |
| 意图搜索 | 识别“适合带娃”涉及房型、设施 | 不擅自把推测写成用户偏好 |
| 代码生成工具 | 对可信表格计算两晚总价 | 在隔离环境执行并限制读写权限 |
| SQL 检索 | 使用结构化条件查库存 | 参数化查询、租户范围、只读账号都需要 |
RAG 作为“提示构造技术”时,应用在调用模型前固定检索;作为“工具”时,模型可以请求不同查询。它们都要留下证据来源,都可能检索失败。增加一个模型检查器,只有在测量显示收益大于延迟与费用时才值得。
可运行的检查与修订练习(扩展实践)
下面是完整、确定性的 Python 3.12+ 标准库示例。保存为 reflection_demo.py,运行 python3 reflection_demo.py。它演示评价规则和反馈,不调用模型。
python
hotels = [
    {"name": "经济旅店", "nightly": 320, "rating": 3.8},
    {"name": "河畔酒店", "nightly": 620, "rating": 4.6},
    {"name": "花园酒店", "nightly": 900, "rating": 4.9},
]
limit, nights, min_rating = 1500, 2, 4.5
candidate = min(hotels, key=lambda h: h["nightly"])
for attempt in range(2):
    errors = []
    if candidate["nightly"] * nights > limit:
        errors.append("总价超过预算")
    if candidate["rating"] < min_rating:
        errors.append("评分不达标")
    print("检查", attempt + 1, candidate["name"], errors)
    if not errors:
        print("通过:", candidate["name"])
        break
    valid = [h for h in hotels
             if h["nightly"] * nights <= limit and h["rating"] >= min_rating]
    if not valid:
        print("没有符合条件的酒店,请调整要求")
        break
candidate = min(valid, key=lambda h: h["nightly"])预期先报告“经济旅店 评分不达标”,再报告“河畔酒店”通过。errors 是业务校验结果;valid 执行硬条件过滤;range(2) 限制修订次数。这里没有任何模型内部推理记录。此独立练习的验证状态见检查报告。
出错怎么办
| 现象 | 常见原因 | 修复方向 |
|---|---|---|
| 检查器总说通过 | 标准只有“请确保高质量” | 拆成预算、日期、引用等可检查字段 |
| 两个 Agent 不断互相否定 | 缺少终止条件和权威数据 | 固定重试次数;把冲突交给明确规则或用户 |
| 修订后丢失已有约束 | 全量重写没有保留结构化状态 | 单独保存不可丢失的目标与已确认事实 |
| 生成代码能读整个磁盘 | 直接执行未经审查的 exec | 使用独立隔离执行器和资源预算 |
| SQL 没有注入但读到别人数据 | 只做了参数化 | 同时强制数据访问范围 |
自测与进一步练习
把最低评分改成 5.0,程序应该怎样退出?再思考:让同一个模型连续自评五次,为什么仍可能错?
参考答案与解释
没有候选满足评分时,输出缺失并退出,而不是悄悄降低标准。连续自评可能重复同一偏差;应引入工具数据、人工标注样本或独立业务校验。练习可将检查逻辑提取成 validate(hotel, requirements),并验证边界总价恰好 1500 可以通过。
本章建立了“检查→有依据地修订→有限退出”的模式。下一章用观测与评估判断这种修订是否真的改善了系统。
原课程代码与补充材料
以下是本章实际源文件对应的阅读页。Notebook 已分解为说明、代码及原文件输出;云端示例未进行联网端到端验证。正文中的片段用于解释,运行时使用完整 Notebook 和准备篇的固定依赖。
本章来源
基于 英文原文 与 简体中文翻译 整理,原作者为 Microsoft 与开源贡献者,采用 MIT 许可证。本页标明“补充讲解”与“扩展实践”的内容为本项目新增。
来源提交:25b7985f3b2d · 获取日期:2026-09-14。参见版本校订记录。